【电子书阅读器】扫描PDF能划词能搜索,本地OCR免费开源
- 2026-11-02 23:04:56
扫描版的 PDF 和图片书,在大多数阅读器里只能放大缩小。文字是图片,划不了词,搜不了内容,做不了笔记。
默读把 OCR 做进了阅读界面。识别出的文字直接进入排版,可以像正常电子书一样调字号、划词、标注、记笔记。识别在本机完成,不需要联网,也不需要 API Key。
扫描书怎么读
裁边、增强、识别,三步
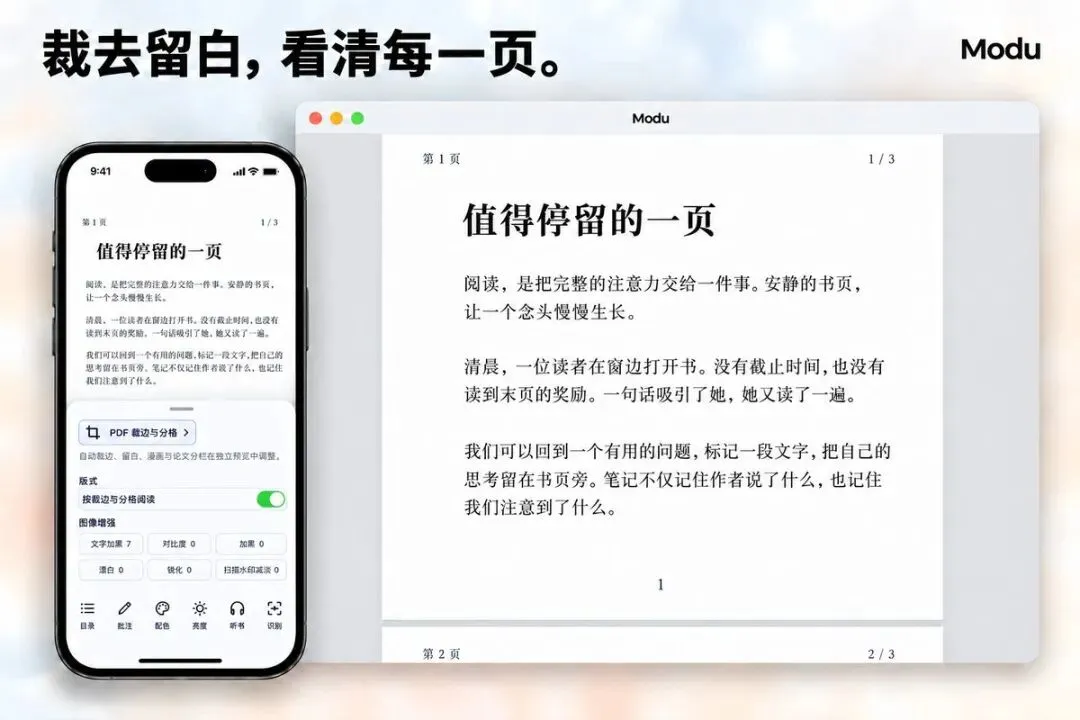
打开扫描书先裁边。自动裁边逐页识别内容边界,也能手动拖框,留少量留白护住页码和脚注。接着是图像增强:文字加黑、对比度、漂白、锐化,参数实时预览,随时对照原图。裁边和增强都不改写原始 PDF。
OCR 装进阅读界面
识别完能直接划词做笔记
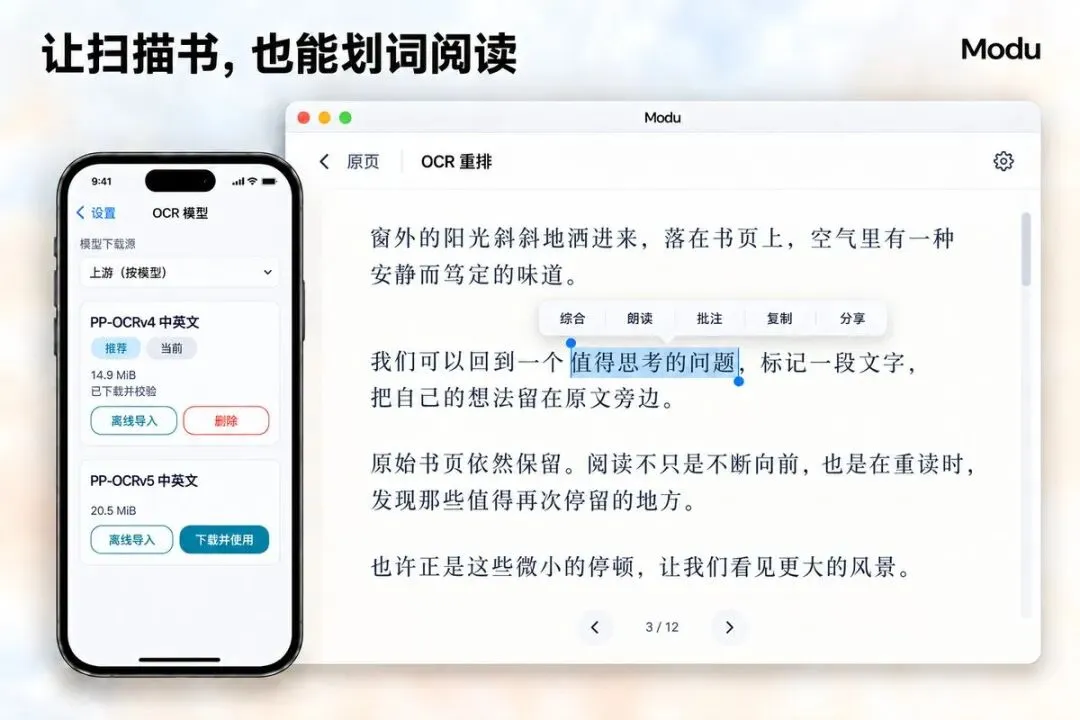
在「设置 → OCR 模型」挑一个下载。推荐先装 PP-OCRv4 中英文版,约 14.9 MiB。模型不塞在安装包里,按需下载,也有离线导入。
PP-OCRv4 中英文约 14.9 MiB
推荐的通用选择
PP-OCRv5 中英文约 20.5 MiB
轻量新版
PP-OCRv3 中英文约 12.5 MiB
更小的备选
PP-OCRv3 英文约 10.9 MiB
英文轻量识别
装好模型,在扫描书菜单里选「OCR 重排」。识别出的文字进入阅读界面后,选词能复制、翻译、标注,也能直接丢给 AI 提问。只要某一段的话用「提取」框选区域,文字进 AI 输入框草稿,改完再发。
识别结果按原书页码存进这本书的缓存文件,下次打开直接读,不用重跑。文字菜单能导出 UTF-8 的 TXT,按「原页码+分隔线+内容」排列。后台预缓存可提前处理当前页和后续 4 页,最多覆盖 5 页。
识别效果受清晰度、语言和版式影响。姓名、数字和复杂分栏,建议对照原图核验一遍。
普通电子书也不将就
排版能调到很细
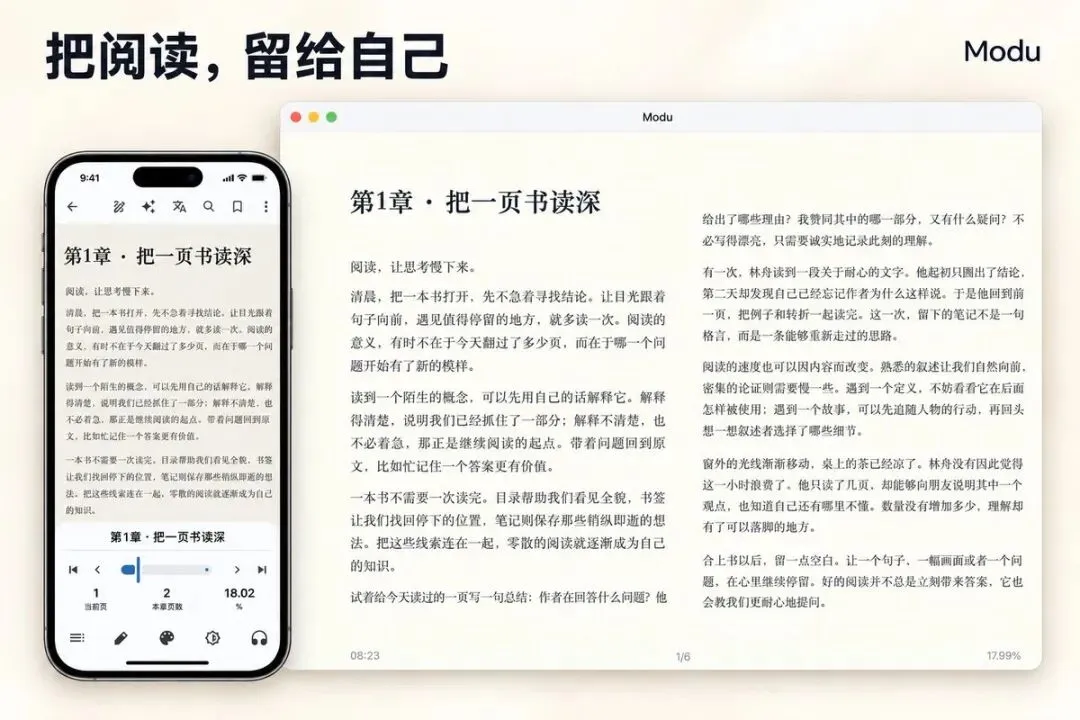
字体、字重、行距、段距、页边距都能调,中英文可分别设字体。字重范围 0.5 到 2.0,步进 0.1。支持横排,也支持竖排配边框栏线。
自定义 CSS 给了 32 个命名位置和 13 个可编辑预设,能让对白变色、给关键词加波浪线、按正则高亮日期。图形界面调颜色间距,需要更细的控制再写 CSS,多套方案独立开关。
01全文翻译
译文直接进书页正文,可「原文+译文」逐段对照,也可只看译文。支持 Google 翻译、AI 翻译、DeepL/DeepLX。
02听书
系统朗读、Edge TTS、小米 MiMo、OpenAI 兼容服务、DashScope。在线语音最高 4 倍速,2 倍以上有独立档位。
03笔记与统计
多种高亮颜色,可导出 Markdown、TXT、CSV。阅读时长、天数、连续阅读、热力图都有。
格式、同步和平台
v1.2.11,2026 年 10 月 18 日发布
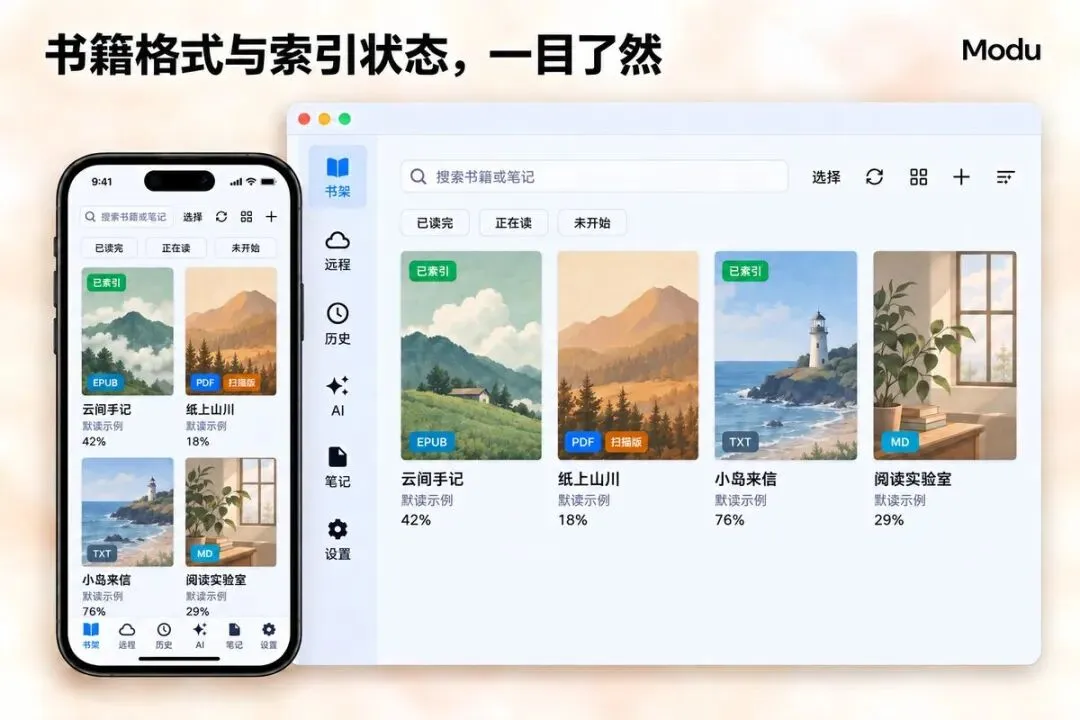
支持 EPUB、PDF、MOBI、AZW3、FB2、TXT、Markdown、文字 UMD 八种格式,加扫描图片书籍。TXT 和 Markdown 导入后转成 EPUB,书架标签仍保留原始格式。
同步走 WebDAV 或 S3 兼容对象存储,书籍、笔记、书签、阅读进度、逐书朗读位置都能同步,也能导出 ZIP 数据库备份。坚果云的限频和冷却保护它有专门处理。
还能给书建向量索引做语义检索,不只查相同字词,也能查意思相近的段落。本地模型四个可选,中文推荐 BGE Small ZH v1.5,512 维。
九个平台:Windows、macOS、Linux、Android、iOS、原生鸿蒙,桌面端各有 x64 和 ARM64 两个架构。Windows 是 EXE 安装器,macOS 是 DMG,Linux 是 DEB,Android 是 arm64-v8a 的 APK。
Windows 版需要 WebView2 Runtime。Windows 11 已内置;Windows 10 缺的话系统会提示,按提示装一次就行。安装包未做商业代码签名,SmartScreen 可能拦一下,点「更多信息」→「仍要运行」。
iOS 的 IPA 没有 Apple 分发签名,需要自行签名才能装。鸿蒙是未签名 HAP,要用鸿蒙证书和 Profile 手动签。macOS 是临时签名、未公证,打开时可能要右键→打开。
项目 2026 年 9 月 5 日开源,一个多月到 191 星。代码用 Dart 写,界面框架是 Flutter。它基于 Anx Reader 和 ReadAny 两个项目实现,按 GPL-3.0-or-later 发布。
如何获取资源
百度 / 夸克双网盘,提取码 modu
也可以后台回复「电子书阅读器」,自动回你网盘链接。
你手里有扫描版的书吗?评论区说说是什么类型,我看看还有没有更合适的工具。
觉得有用点个「在看」。

