4.4 万本电子书,一个网页就能搜索,还能免费获取
- 2026-11-21 12:19:02
家里的 NAS 里躺着 4 万多本电子书:中华书局经典、经济学人、投行研报、数学物理教材、各种考试资料……过去它们只是目录里的文件名,我知道它们在那儿,却很少真的翻开。
于是我照着自己那个「逆光的影视库(https://movies.yuan-xin.top/)」的样式,做了一个电子书库:逆光书库。
一句话:4.4 万个文件、3.5 万张卡片、295 GB,一个浏览器地址就能翻;游客能看目录,注册用户能读,管理员能加 NAS 目录。
先看长什么样
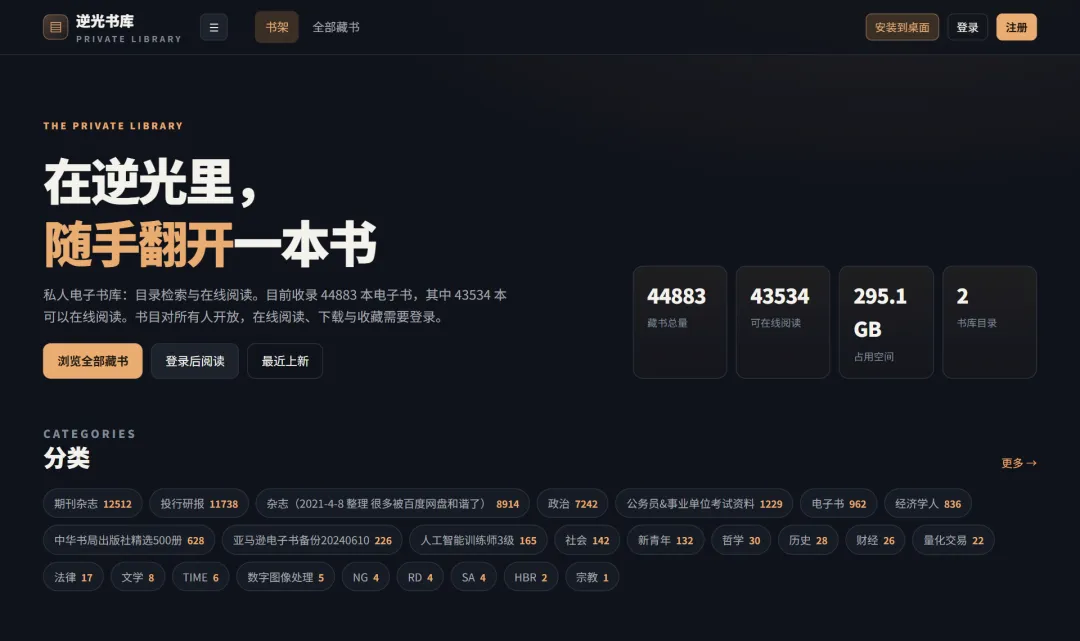
首页:藏书总量、可在线阅读数量、占用空间与分类;深色书墙,暖色是唯一的高亮。
打开就是书架:左边一句「在逆光里,随手翻开一本书」,右边四个数字——4.4 万个文件、4.3 万本可读、295.1 GB、2 个书库。下面按分类铺开:期刊杂志、投行研报、中华书局精选、亚马逊电子书备份……点一下就能进。
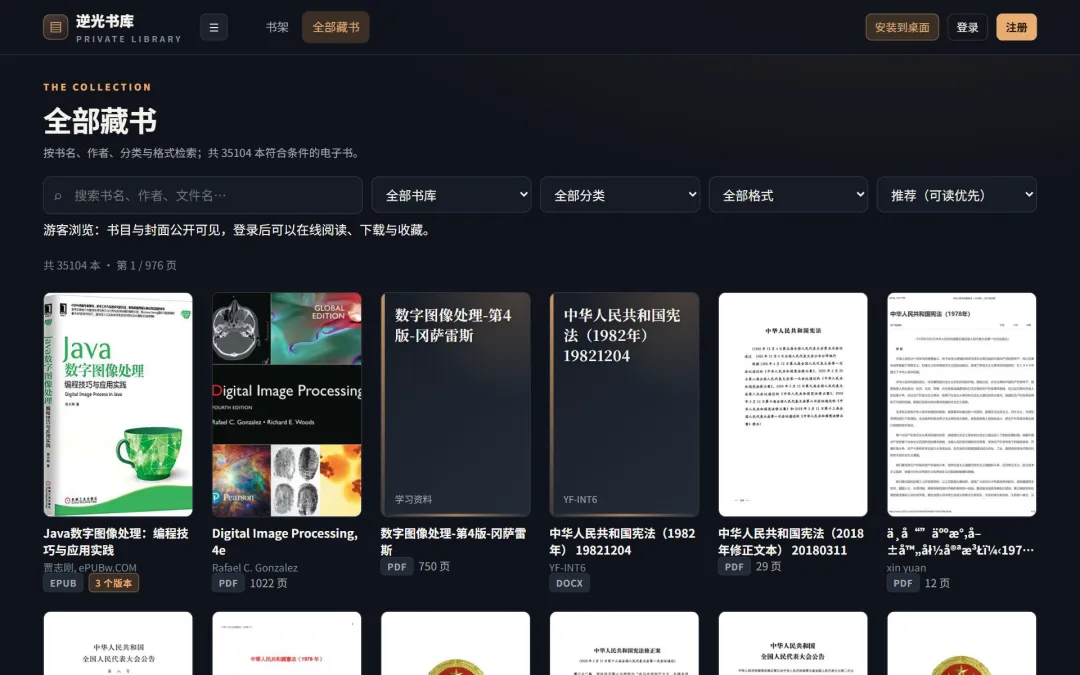
全部藏书:搜索、书库、分类、格式、排序五个筛选器,下面是封面书墙。
搜索支持书名、作者、文件名、分类、丛书、出版社;排序有「推荐(可读优先)」「最近入库」「书名」「作者」「出版年份」「文件大小」。翻到第 976 页也不会乱。
五个让我天天用的细节
1. 一个书名,只出现一张卡片
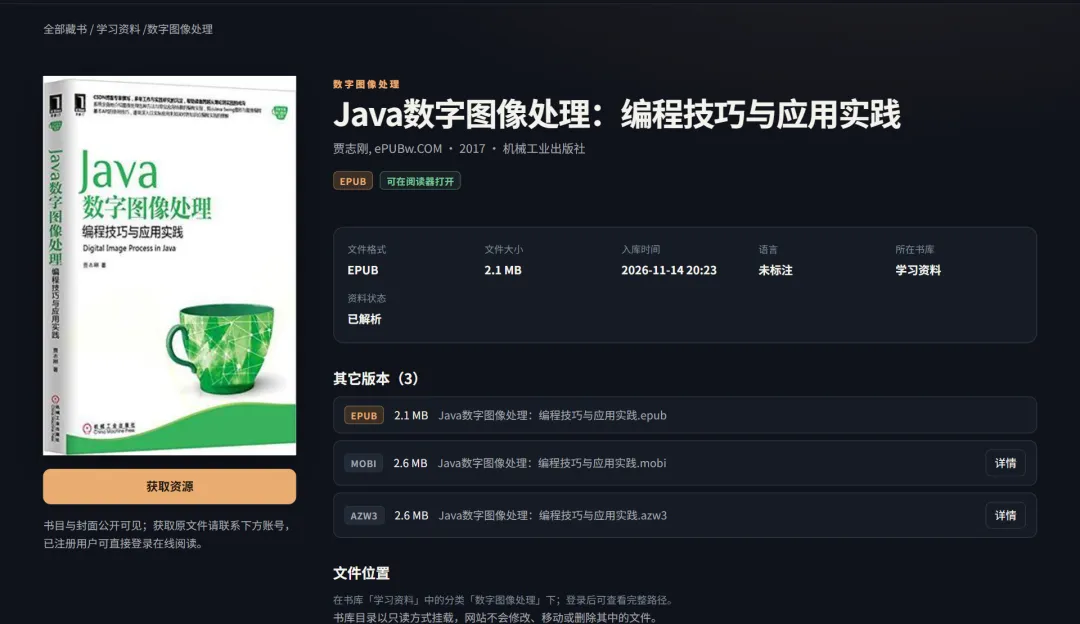
同一本书的 EPUB / MOBI / AZW3 合成一张卡片,标「3 个版本」;详情页里可以逐个切换。
同一本书往往有好几个格式:EPUB 排版最好,MOBI 是当年用 Kindle 时下的,PDF 是扫描版。以前在文件管理器里它们是三个文件,现在合并成一张卡片——4.4 万个文件最后合并成 3.5 万张卡片,卡片上写着「3 个版本」;详情页里点「详情」就能切到任何一个,读书时按格式挑最舒服的那个。
合并规则很简单:按归一化后的书名分组(全半角、标点、下载站后缀都会被清掉),可疑书名——比如 PDF 元数据里那种 Title、QQ629748720——不参与合并,免得把几百本不相干的书挤进一张卡片。期刊按「期号」区分,也不会被合并。
2. 真的能读,而不只是「有」
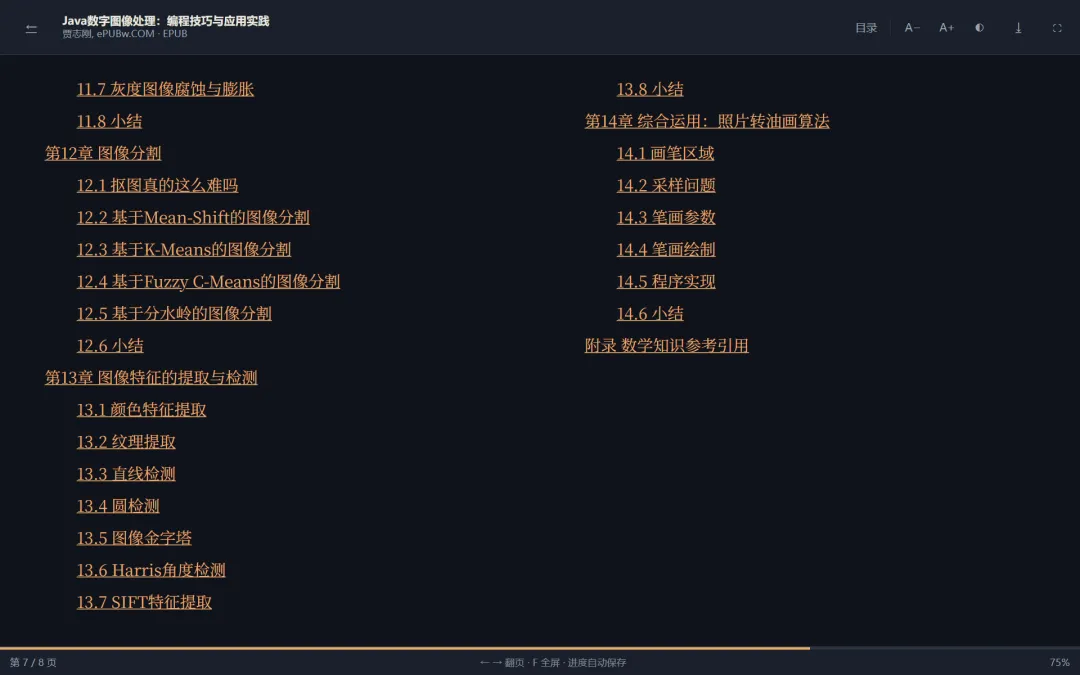
EPUB 用 epub.js 原样渲染,夜间/护眼/日间三种配色,字号可调,进度自动保存。
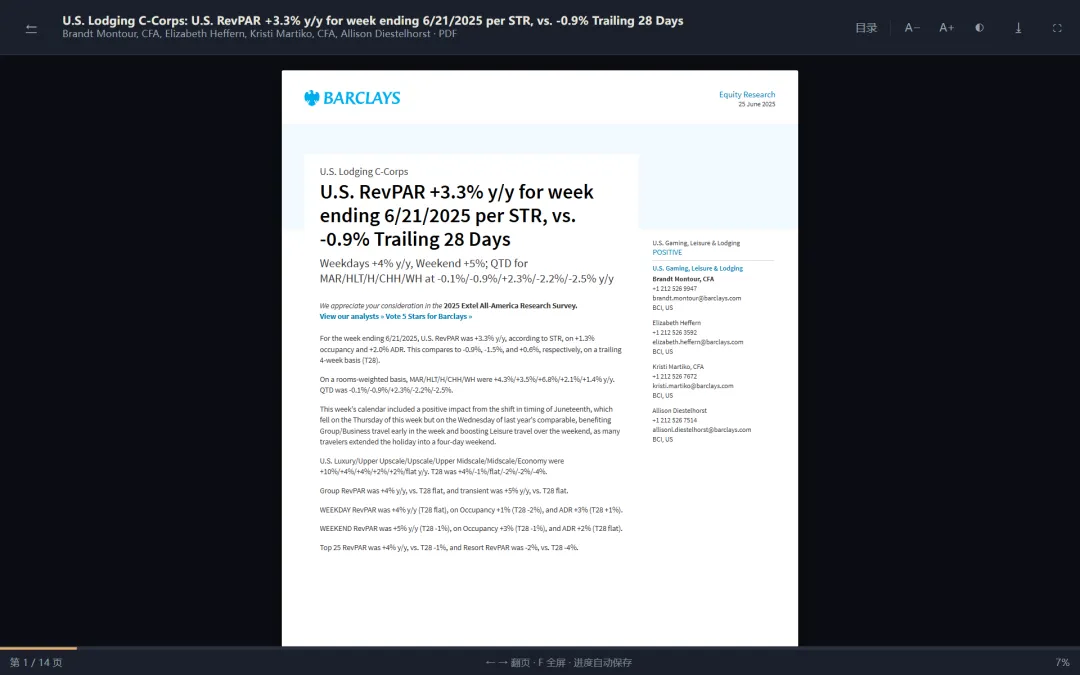
PDF 用 pdf.js,按页懒加载、Range 分段拉取,上千页的大书也能先开第一页。
支持的格式比预期多:EPUB、PDF、TXT、Markdown、FB2、DOCX 都能直接读;MOBI / AZW3 / AZW 会在服务端转成标准 EPUB(补上 mimetype 与 container.xml)再交给阅读器。三种配色、字号调节、目录、键盘翻页、手势翻页、进度自动保存——读到一半关掉页面,回来接着读。
PDF 走 Range 分段请求,几百 MB 的扫描版可以边下边看;手机浏览器上同样能用。
3. 游客也能逛,想读再登录
我把「目录」和「内容」拆开了:任何人都能浏览书目、封面、详情和分类;但在线阅读、下载、收藏、阅读进度需要注册(邀请码制)。没有账号的人点详情页的「获取资源」,会弹出我的小红书、微信公众号二维码和知乎——关注后私信,写明书名即可。
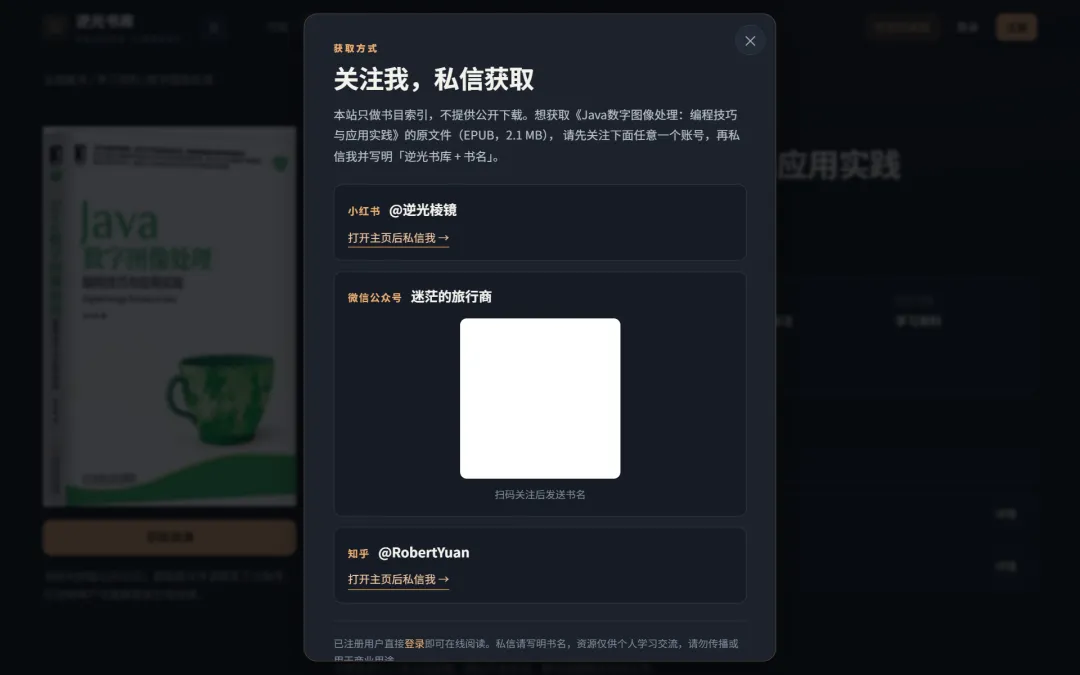
游客的详情页只有一个「获取资源」:小红书 / 微信公众号 / 知乎,关注后私信索取。
4. 手机上是真的能用
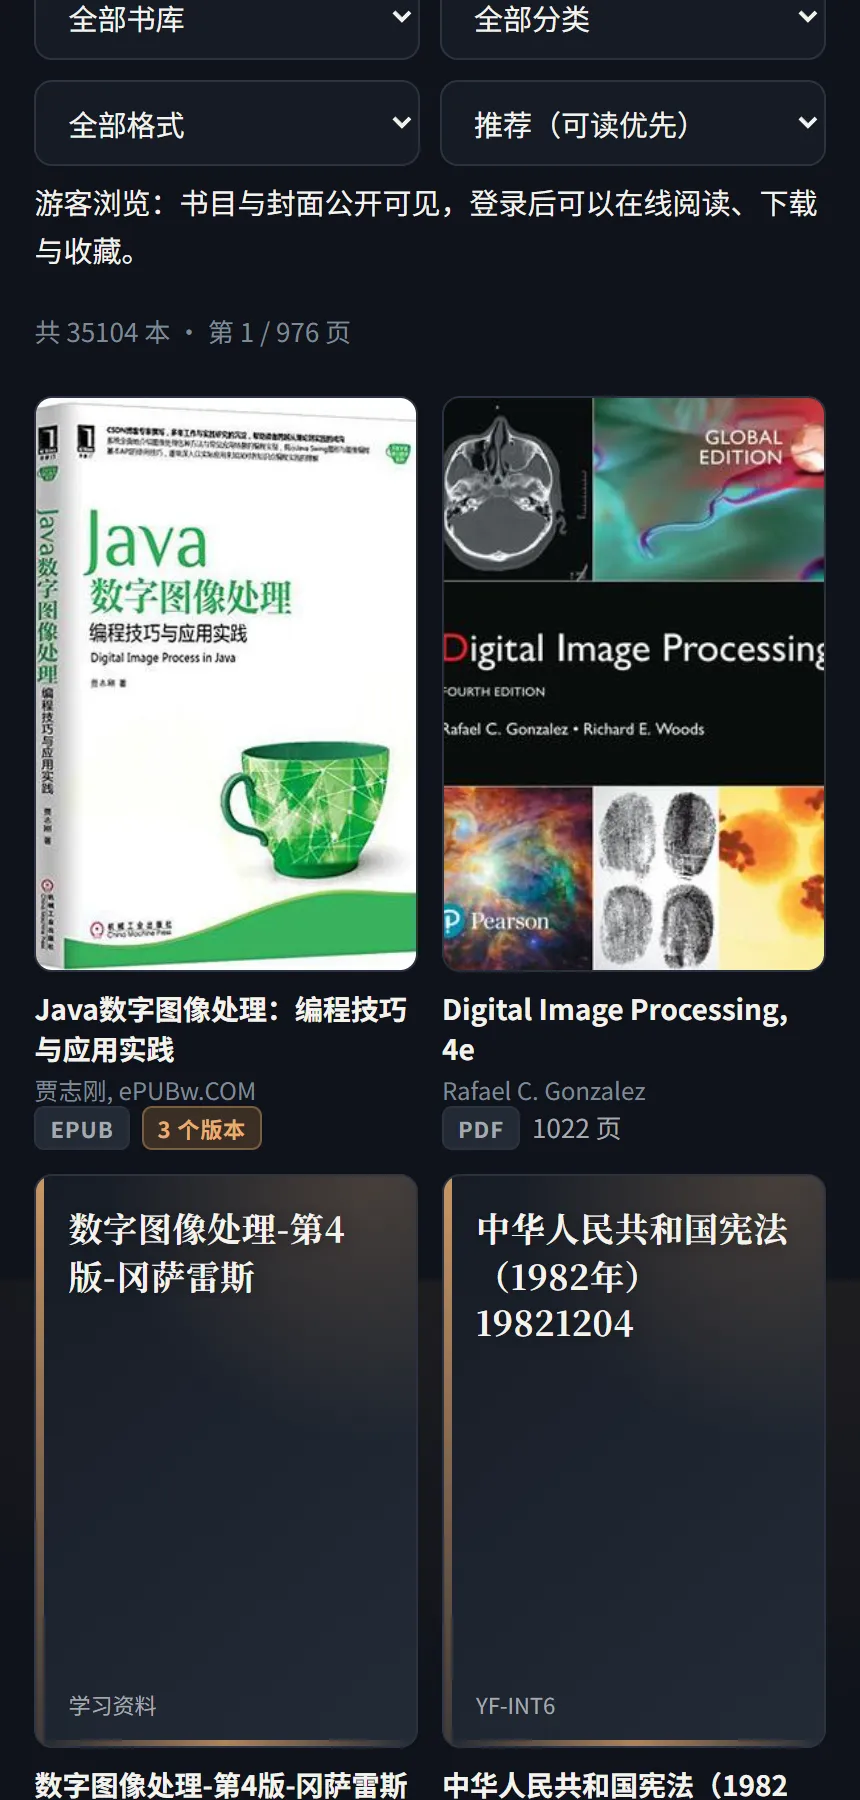
手机端两列书墙,筛选器自动折行;PWA 可以「添加到主屏幕」。
PWA:用 HTTPS 打开后可以「安装到桌面」,图标和名字都和网页一致;断网时至少有离线提示页,不会白屏。
5. 管理员视角:加目录、发邀请码、看审计
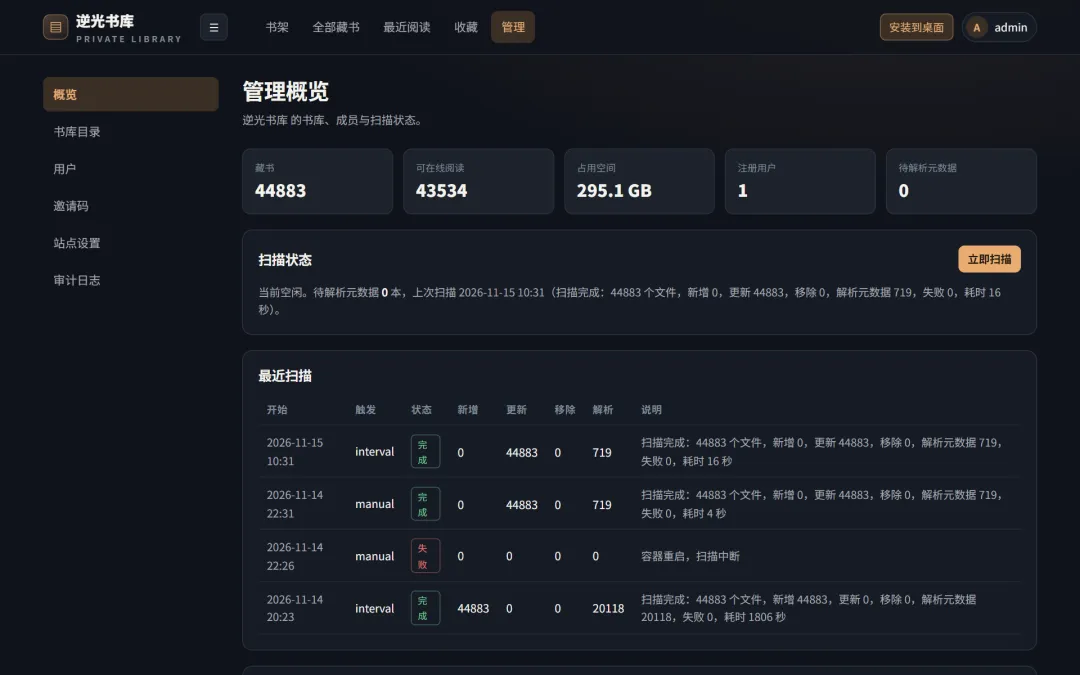
后台概览:扫描状态、最近扫描记录、书库目录、注册用户;还有用户、邀请码、站点设置、审计日志。
新增 NAS 目录只要填一个容器内路径(必须落在已挂载的根目录下),保存即安排扫描;邀请码可以限制次数和有效期;登录、改权限、触发扫描、API/MCP 写操作都会留审计记录。
它是怎么做出来的
技术栈刻意选得很「土」,但够用、好维护:Python 3.12 + FastAPI + SQLite,页面是服务端渲染的 Jinja2 模板,前端只有几百行原生 JS 和两个阅读器库,PWA 用 Service Worker 做壳缓存。
扫描分两阶段:先遍历入库(几分钟内就能先浏览目录),再后台解析元数据与封面;
增量扫描十几秒——文件没变就不重新解析,只有新增或 mtime/size 变化才进队列;
每本书入库时按「可读 + 有封面」挑代表版本,缺封面的分组不会挤到首屏;
PDFium 不是线程安全的,PDF 解析全局串行,避免并发渲染把进程搞崩;
部署走 GitHub → Jenkins → Portainer:Jenkins 每 30 分钟轮询,用 Portainer API 在 NAS 上构建镜像、更新 Stack、跑健康检查,全程不 SSH 登录 NAS;
AI 接入是顺手做的:/api/v1 REST + /mcp MCP 服务(13 个工具),可以让 AI 检索书目、读正文片段、记阅读进度。(https://github.com/yuan-xin-9997/books-catalog/blob/main/docs/API%E4%B8%8EMCP%E6%8E%A5%E5%85%A5.md)
隐私与边界
书库目录以只读方式挂载,网站不写、不移动、不删除 NAS 文件;
注册制 + 邀请码,会话、CSRF、登录/注册限流、审计日志齐备;
游客看不到 NAS 路径,也看不到完整相对路径;
限制也说清楚:DOC/DJVU/CHM/CBZ 只登记可下载、不在线阅读;扫描版 PDF 没有文本层,AI 取不到正文;期刊按期号不合并。
在哪儿
书库:https://books.yuan-xin.top
源码:https://github.com/yuan-xin-9997/books-catalog
版本记录:https://github.com/yuan-xin-9997/books-catalog/releases
影视库(同款设计):https://movies.yuan-xin.top
如果你也有 NAS 和一堆电子书,欢迎 fork 自建;想看书但没有邀请码,私信我,说明书名就行。

