OCR 电子书之我见(续):用 SoMark 解放大模型
- 2026-10-23 11:19:43
在上一篇《OCR电子书之我见》里,我介绍了配合 Antigravity 使用的全自动制作电子书的 Skill(pdf-book-ocr[1])。
那个方案虽然能跑通,但实际用下来有两个问题:
一个是慢。整本书全靠多模态大模型做视觉转录,中途要等挺久;
另一个是费 token。一整本书的页面全当成图片传给大模型,token 消耗相当大。如果中途格式不理想需要重试,用量掉得就更快了。
秉承着“面向小红书编程”的优良传统,我在评论区网友的安利下看到了 SoMark[2]。
去官网看了一下,发现它是专门做文档解析的工具,目前每个月有 2000 页的免费额度,每天限 500 页,个人平时转几本书完全够用。
试了一下,在识别速度上确实比通用大模型快得多,排版的还原度也算不错。既然有了轻量且专业的工具,大模型就完全不需要再当“抄书苦力”了。
于是我重新写了一个新的 Skill:somark-book-epub[3]。
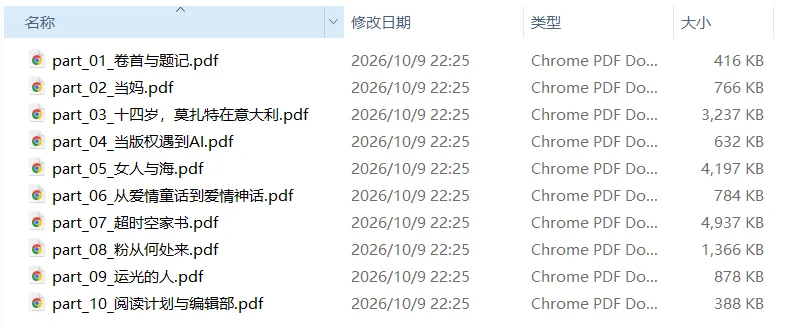
这次最大的改动,是放弃了上一代每 15 页硬切一刀的做法,改成按真实篇目切片。
只要切片的物理边界就是文章的自然章节,切片末尾正好是文章结尾,跨切片的断句问题就从根本上消失了。上一版写的那些接缝检查、断句拼接代码,直接全部删掉。
实现起来分两种情况:
1PDF 自带书签大纲:脚本直接按书签层级和页码,把全书切成一个个独立的章节 PDF;
2纯扫描件、没有书签的 PDF:书上印的页码,和 PDF 阅读器里的物理页码往往对不上,前面有封面、扉页、序言和目录占了十几页。脚本会先导出前十几页做个预览,我们翻一下正文第一章在 PDF 里的实际页码,拿它减去目录上印的页码,就能算出固定的偏移量。比如第一章印的是第 1 页,在 PDF 里实际是第 12 页,偏移量就是 +11。把目录上的页码全加上 11,就能准确按篇目切开。
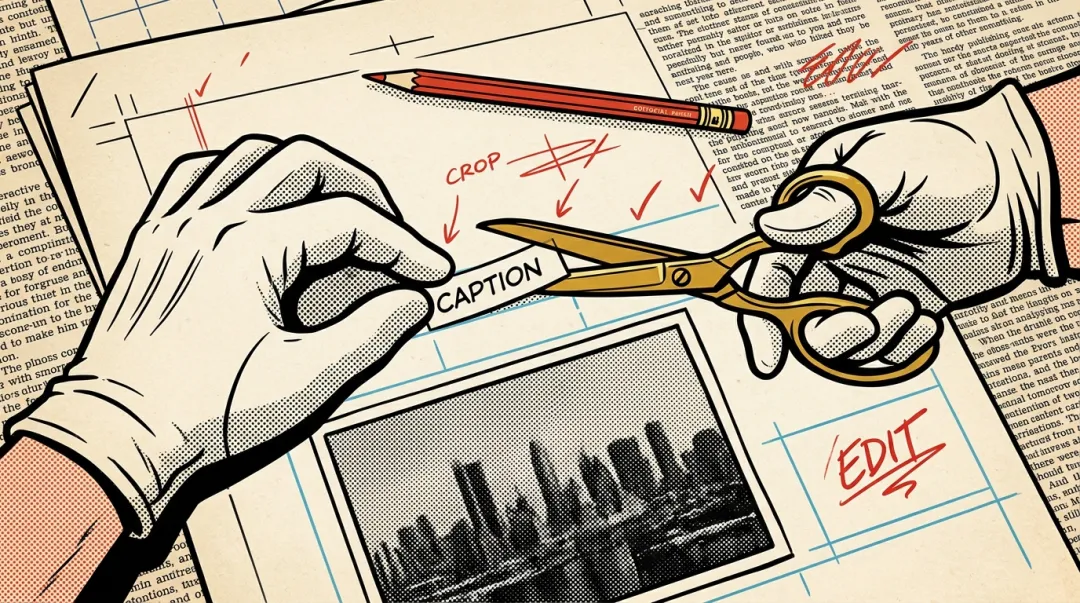
底层的文字识别和配图下载交给工具后,大模型只需要负责校对文本。
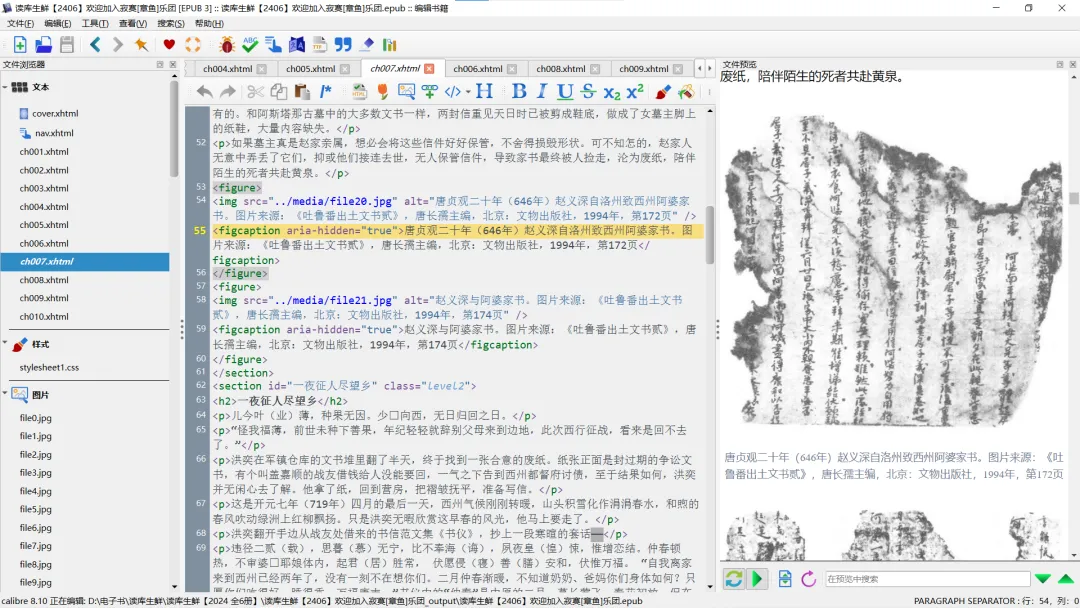
比如:OCR 输出时,经常把图片正下方的短说明(比如“工作台前的我。”)识别成普通正文,导致这段图注带着首行缩进混在故事里,显得很不协调。
大模型负责判断图片下方的短句是不是在给图片做说明,如果是,就提取到 Markdown 图片语法  里面,并在正文中删掉这一行。这样编译出来的 EPUB 就会呈现正规居中、无缩进的图注样式。
这个新 Skill 已经开源在 GitHub,支持在各种 Agent 工具中作为 Skill 使用。有需要的朋友可以去 SoMark 注册一下,复制 API key 配合使用。
参考链接 / REFERENCES
[1] pdf-book-ocr: https://github.com/joffoo/pdf-book-ocr
[2] SoMark: https://somark.cn/
[3] somark-book-epub: https://github.com/joffoo/somark-book-epub
我是游戏客人 Joffoo,专注于在 AI 世界里走神。
欢迎点赞、关注、转发,我们下篇见。

