离线电子书阅读器:TXT/EPUB 自动识别编码 + 分块加载
- 2026-11-14 23:50:33
网上小说阅读器要么弹广告要么账号登录,想安静看点经典古籍、外文小说?本文是一个纯标准库的本地电子书阅读器:TXT 自动识别 UTF-8 / GBK / GB18030 / Big5 编码,EPUB 手写解析 OPF spine + NCX/Nav 目录,大文件按字节偏移分块惰性加载(10MB 的书不占内存),中文小说自动生成"第X章"目录。阅读进度、书签、生词本全存本地
books.json,完全离线。复制源码保存即可运行。
一、它能做什么
| 能力 | 说明 |
|---|---|
| TXT 编码自动识别 | UTF-8 / UTF-8-SIG / GB18030 / Big5 / Latin-1 五种,采样前 256KB 用增量解码器判断,避免截断在半字符上误判 |
| EPUB 零依赖解析 | zip 容器 + OPF manifest + spine 顺序 + NCX/Nav 目录,手写 HTMLParser 把 XHTML 章节转纯文本 |
| 大文件惰性加载 | 按 12000 字符左右分块,扫描行边界生成字节偏移表,只在跳转时解码目标块 |
| 自动目录 | 中文小说常见的 第X章/节/回/卷/集/部 正则匹配;EPUB 直接读作者目录 |
| 进度精确续读 | 按 单元索引 + 滚动比例(frac,4 位小数)记录,下次打开精确回到上次位置 |
| 三档主题 | 日间(白/深灰)、护眼(豆绿/墨绿)、夜间(深灰/浅灰),字号 11~30 可调 |
| 生词本 | 选中正文 → 右键/按钮一键存生词,带语境行;支持查看语境、删除 |
| 书签 | 任意位置加书签,带当前单元标题 + 滚动位置,双击跳转 |
| 阅读时长统计 | 每 5 秒 tick 累加,状态栏显示;10_000 ms 自动保存 |
| 文件缺失容错 | 打开书库时源文件被删?弹框询问是否移出书库;损坏 JSON 自动备份为 .json.bak |
仅依赖标准库(tkinter / zipfile / HTMLParser / re / json / tempfile / codecs / os / posixpath)。
二、运行方式
# 要求:Python 3.10+
python book_reader.py
首次运行会自动创建 books.json(同目录),存放书库、进度、书签、生词本。
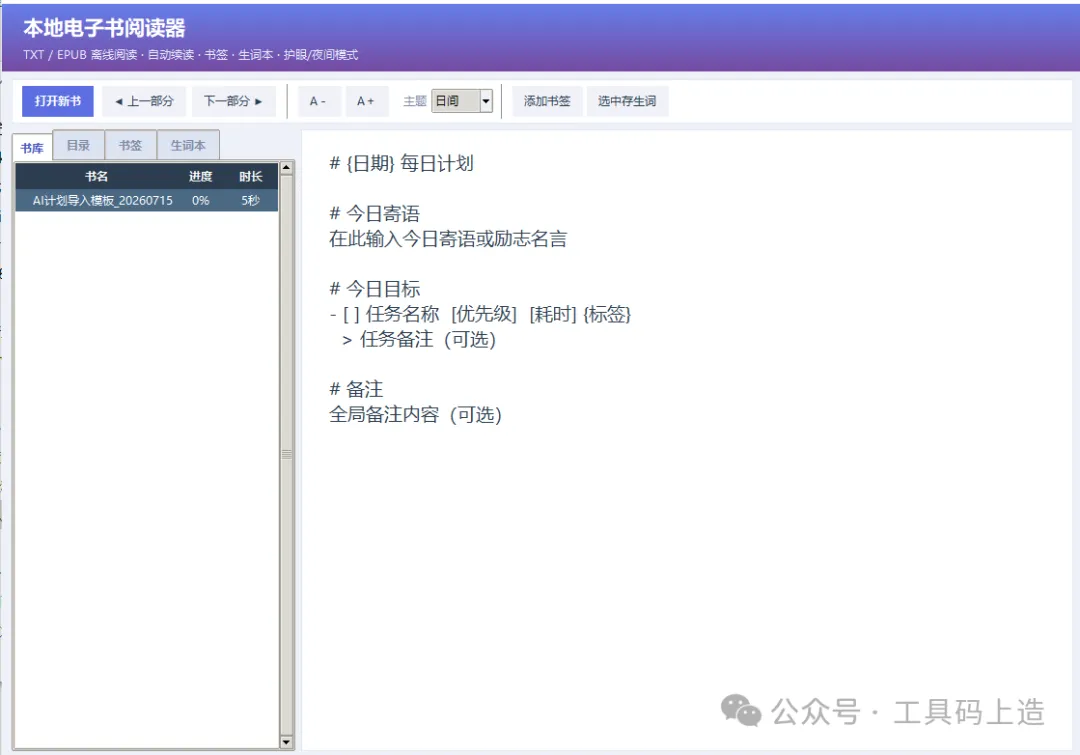
三、界面结构
┌──────────────── 渐变横幅(本地电子书阅读器)──────────────────────┐
│     TXT / EPUB 离线阅读 · 自动续读 · 书签 · 生词本 · 护眼/夜间模式    │
├────────────────────────────────────────────────────────────────────┤
│ [打开新书] [◀上一部分] [下一部分▶]   A- A+ 主题:[日间▼]  [书签][生词] │
├──────────────┬─────────────────────────────────────────────────────┤
│ 左侧栏       │ 阅读区                                              │
│ ┌Notebook─┐ │ ┌─────────────────────────────────────────────────┐ │
│ │书库      │ │ 《三体》第二部 第 7 部分(约 42%)                │ │
│ │目录      │ │                                                   │ │
│ │书签      │ │   你以为这是开始?这一切才刚刚开始...             │ │
│ │生词本    │ │                                                   │ │
│ └─────────┘ │   ——黑色,是宇宙的底色;而文明,                 │ │
│              │     不过是偶然闪过的一缕光。                       │ │
│ 书库列表:   │                                                   │ │
│ 《三体》 42% │                                                   │ │
│ 《百年孤独》 │                                                   │ │
│ 《活着》    │ │                                                   │ │
│              │                                                   │ │
│              │ 右键正文:存生词 / 加书签                           │ │
├──────────────┴─────────────────────────────────────────────────────┤
│ 《三体》 第 7 部分(约 42%) 全书约 42% 累计阅读 1小时23分 Alt+←/→ │
└─────────────────────────────────────────────────────────────────────┘
四、功能使用说明
4.1 打开一本电子书
点工具栏「打开新书」选 .txt 或 .epub 文件。第一次打开会扫描 TXT 编码和分块(大文件需要几秒),EPUB 秒开。文件会自动加入书库。
双击左侧书库列表即可续读;关闭程序后下次打开自动续读最近一次阅读的书,精确到上次滚动位置(frac 保留 4 位小数,误差 ≤ 1 屏)。
4.2 翻页 / 切换章节
Alt+← / Alt+→:上一个/下一个块(TXT)或章节(EPUB)
左侧「目录」页签:直接跳转任意章节(EPUB 显示作者目录;TXT 显示自动识别的章节或按比例分的"第 N 部分")
工具栏「◀ 上一部分 / 下一部分 ▶」按钮
4.3 主题 / 字号
工具栏下拉切换三档主题;Ctrl + / - 或 A+ / A- 按钮调节字号(11~30),设置自动存进 books.json,下次打开沿用。
4.4 书签 / 生词本
点「添加书签」或正文右键「在此处添加书签」,默认书签名是当前章节标题,可自定义
选中正文 → 点「选中存生词」或右键 → 生词本自动加入,附带选中行语境;去重检测(已有相同生词跳过)
生词本双击可查看完整语境(哪本书、哪一行、什么时间存的)
4.5 文件管理
书库右键:打开 / 资源管理器定位 / 从书库移除(不删原文件,只删进度和书签)。打开时如果源文件被移/删,会弹框问你要不要从书库移除这条无效记录。
五、技术要点 1:编码识别用增量解码器,避免截断半字符
大文件的前 256KB 采样可能正好截在 UTF-8 的多字节字符中间(比如 "我" = \xe6\x88\x91,采样如果在 \xe6 后截断),普通 decode 会抛 UnicodeDecodeError。解法:用 codecs.getincrementaldecoder 的 final=False 模式——允许样本末尾有不完整字符,只要中间能全部解出来就算数:
defdetect_encoding(sample: bytes) ->str:
ifsample.startswith(b"\xff\xfe") orsample.startswith(b"\xfe\xff"):
return"utf-16"
ifsample.startswith(b"\xef\xbb\xbf"):
return"utf-8-sig"
forencin ("utf-8", "gb18030", "big5", "latin-1"):
try:
dec = codecs.getincrementaldecoder(enc)(errors="strict")
dec.decode(sample, final=False)   # 末尾截断字符不算错
returnenc
exceptUnicodeDecodeError:
continue
return"gb18030"# 兜底:GB18030 基本能解所有中文
顺序是 UTF-8 → GB18030 → Big5 → Latin-1:UTF-8 最严格(多字节合法序列受限),能过就准是 UTF-8;GB18030 是中文超集,兜底万无一失。
六、技术要点 2:TXT 大文件按行分块,字节偏移永不切多字节
10MB 的《明朝那些事儿》如果一次性 read_text() 全读进来,tkinter 的 Text 组件会卡死 3 秒以上。解法是扫描行边界:
classTxtBook:
def__init__(self, path):
self.encoding = detect_encoding(f.read(262144))
self.offsets = [0]           # 字节偏移表(每个块的起始位置)
chars = 0
forrawinf:                # 逐行读,天然按 \n 切
# 这里正好在换行符之后 → UTF-8/GBK 多字节字符一定完整
chars += len(line)
ifchars>= 12000:      # BLOCK_CHARS = 12000
self.offsets.append(f.tell())
chars = 0
关键:for raw in f: 逐行迭代时,Python 文件对象的缓冲在换行符后停下,所以每行的字节序列一定完整——不存在"切到 UTF-8 三字节字符中间"的可能。块边界存在 self.offsets 列表里(纯整数),跳回第 N 块只要 f.seek(offsets[N])。
加载时按需只解码目标块:
defread_unit(self, i: int) ->str:
start = self.offsets[i]
end = self.offsets[i+1] ifi+1<len(self.offsets) elseNone
f.seek(start)
data = f.read(end-start) ifendelsef.read()
returndata.decode(self.encoding, errors="replace")
七、技术要点 3:章节自动扫描,一条正则匹配中文小说
中文网络小说和古典小说的章节标题很有规律——"第一章"、"第25回"、"卷二 风起"。一条正则全搞定:
CHAPTER_RE = re.compile(
r"^\s*第\s*[0-9零一二三四五六七八九十百千两]+\s*[章节回卷集部].{0,28}$")
意思是:行首零个或多个空格 → 可选"第"(允许空格分隔)→ 阿拉伯数字或中文数字(零到千两)→ 章节类型字(章/节/回/卷/集/部)→ 后面可跟不超过 28 个字符的标题正文(排除整行太长的误判)。
扫描时每行尝试匹配,匹配成功就记一个章节锚点:
stripped = line.strip()
iflen(stripped) <= 40andCHAPTER_RE.match(stripped):
block = len(self.offsets) -1# 这个章节落在当前块
self.chapters.append((block, stripped))
如果一本书一行这种章节标题都没有(比如纯散文),就按分块比例生成"第 1 部分 / 第 2 部分 ..."。
八、技术要点 4:EPUB 手写解析,零 zipfile/XML 之外的依赖
EPUB 本质是一个 zip 包,里面装一堆 XHTML 文件 + 一个 OPF 清单文件(说明"哪些文件按什么顺序读")。标准库 zipfile 已经能打开 zip,剩下的全是字符串解析。EPUB 的结构:
EPUB.zip
├── META-INF/container.xml       ← 指向 OPF 文件位置
├── content.opf                   ← manifest + spine(核心)
└── OEBPS/
    ├── chapter-1.xhtml           ← 实际正文
    └── toc.ncx / nav.xhtml       ← 目录(两种格式)
解析流程三步:
Step 1 找 OPF 文件路径:读 container.xml,正则抓 full-path 属性:
def_find_opf(self) ->str:
container = self.zf.read("META-INF/container.xml").decode("utf-8", "ignore")
m = re.search(r'<rootfile\b[^>]*full-path="([^"]+)"', container)
returnm.group(1)
Step 2 读 OPF,提取 manifest(文件表)和 spine(阅读顺序):
# manifest:所有章节文件
forminre.finditer(r"<item\b[^>]*/?>", opf, flags=re.I|re.S):
a = _attrs(m.group(0))
manifest[a["id"]] = (a["href"], a.get("media-type", ""), ...)

# spine:规定阅读顺序(按 idref 指向 manifest 里的 id)
spine_m = re.search(r"<spine\b[^>]*>(.*?)</spine>", opf, flags=re.I|re.S)
idrefs = re.findall(r'<itemref\b[^>]*idref="([^"]+)"', spine_m.group(1))
Step 3 章节标题:EPUB 有两种目录格式——NCX(传统 .ncx 文件)和 Nav(新 nav.xhtml 文件带 properties="nav"),先试 NCX,没有就试 Nav:
def_titles_from_ncx(self, manifest) ->dict:
# 找 manifest 里 media-type 含 ncx 的那个文件
ncx_href = self._norm(ncx)
xml = self._read_text(ncx_href)
# navPoint 条目里同时有 <text>(标题)和 <content src="...">(章节文件)
pat = re.compile(
r"<navPoint\b.*?<text[^>]*>(.*?)</text>.*?<content\b[^>]*src=\"([^\"]+)\"",
flags=re.I|re.S)
forminpat.finditer(xml):
title = _TAG_RE.sub("", m.group(1)).strip()   # 清掉 <text> 里的 <em> 等子标签
out[章节文件路径] = title
九、技术要点 5:XHTML 转纯文本,HTMLParser 子类搞定
EPUB 章节是 XHTML(HTML 的 XML 版),要显示成纯文本又要保留段落换行——继承标准库 HTMLParser,只关心几个关键标签:
class_HtmlToText(HTMLParser):
BLOCK = {"p", "div", "br", "h1", "h2", "section", "article", ...}

defhandle_starttag(self, tag, attrs):
iftagin ("script", "style"):
self._skip += 1# 跳过 JS/CSS
iftaginself.BLOCK:
self.parts.append("\n")     # 块级标签前插换行

defhandle_endtag(self, tag):
iftagin ("script", "style") andself._skip:
self._skip -= 1
iftagin ("p", "h1", "div", "li"):
self.parts.append("\n")     # 段落后换行

defhandle_data(self, data):
ifnotself._skip:
self.parts.append(data)     # 非 script/style 才保留

deftext(self) ->str:
out = re.sub(r"[ \t]*\n[ \t]*", "\n", out)   # 去行首尾空格
out = re.sub(r"\n{3,}", "\n\n", out)          # 压缩三连以上空行
returnout.strip()
十、技术要点 6:进度精确续读,单元索引 + 滚动比例双保险
只记"第几章"不够——一章可能 200 屏。解法:单元索引 + 滚动比例 frac:
# 保存
self.meta["progress"] = {"index": self.unit_index,          # 第几个块/章
"frac": round(self._current_frac(), 4)}  # 滚动条位置(0~1)

# 恢复
self.unit_index = meta["progress"]["index"]
self.load_unit(self.unit_index, meta["progress"]["frac"])
frac 取 reader.yview()[0](tkinter 原生滚动比例,4 位小数精度,误差 ≤ 1 屏)。
十一、技术要点 7:原子保存防崩溃,tempfile + os.replace
直接 open("books.json", "w") 写一半程序崩溃就留下半截脏 JSON。解法:临时文件 + 原子重命名:
defsave(self):
fd, tmp = tempfile.mkstemp(prefix="books_", suffix=".json",
dir=str(self.path.parent))
withos.fdopen(fd, "w", encoding="utf-8") asf:
json.dump(self.data, f, ensure_ascii=False, indent=1)
os.replace(tmp, self.path)   # 跨平台原子替换
读取时如果 JSON 损坏,自动把原文件改名为 .json.bak 备份,再清空重建:
except (json.JSONDecodeError, OSError):
bak = self.path.with_suffix(".json.bak")
self.path.rename(bak)
十二、完整源码
以下是 book_reader.py 全文,复制保存即可运行(需要 Python 3.10+)。
# -*- coding: utf-8 -*-
from__future__importannotations
"""
本地电子书阅读器(#15)
======================
- 支持 TXT(自动识别 UTF-8 / GBK / GB18030 / Big5 编码)
  与 EPUB(zip 容器,解析 OPF spine + NCX/Nav 目录)
- 大 TXT 按行切"块"惰性加载(不一次性进内存),
  中文小说常见的"第X章"自动生成目录
- 阅读进度按"单元(块/章)+ 滚动比例"记录,下次打开自动跳回;
  书签、阅读时长统计、生词本
- 三档主题(日间 / 护眼 / 夜间)与字号调节
- 边界:文件被删时提示并可移出书库;数据原子写入 books.json;完全离线
仅依赖 Python 标准库。
"""

importjson
importos
importre
importsys
importtempfile
importtime
importtkinterastk
importzipfile
fromdatetimeimportdatetime
fromhtml.parserimportHTMLParser
frompathlibimportPath
fromtkinterimportfiledialog, messagebox, ttk
fromurllib.parseimportunquote
importposixpath

# ---------------------------------------------------------------------------
# 常量与配色
# ---------------------------------------------------------------------------

APP_BG = "#eef1f8"
CARD_BG = "#ffffff"
TEXT_DARK = "#2c3e50"
TEXT_GRAY = "#7f8aa3"
ACCENT = "#5b6ee1"
ACCENT_DARK = "#4453c0"
GREEN = "#27ae60"
RED = "#e74c3c"
ORANGE = "#e67e22"
BORDER = "#e3e7f2"
HEADER_BG = "#2c3e50"
GRAD1, GRAD2 = "#667eea", "#764ba2"
FONT = "Microsoft YaHei UI"

DATA_FILE = "books.json"
BLOCK_CHARS = 12000# TXT 每个加载块的目标字符数
SAVE_INTERVAL_MS = 10_000# 自动保存间隔
TICK_MS = 5_000# 阅读时长累计间隔

THEMES = {
# 主题名: (阅读区底色, 文字色)
"日间": ("#ffffff", "#2c3e50"),
"护眼": ("#cce8cf", "#23402a"),
"夜间": ("#1e1f22", "#c9c9c9"),
}

CHAPTER_RE = re.compile(
r"^\s*第\s*[0-9零一二三四五六七八九十百千两]+\s*[章节回卷集部].{0,28}$")


defapp_dir() ->Path:
"""脚本所在目录,数据文件 books.json 也放在这里。"""
returnPath(__file__).resolve().parent


defenable_dpi() ->None:
try:
importctypes
ctypes.windll.shcore.SetProcessDpiAwareness(1)
exceptException:
try:
importctypes
ctypes.windll.user32.SetProcessDPIAware()
exceptException:
pass


defhex_rgb(c: str):
returnint(c[1:3], 16), int(c[3:5], 16), int(c[5:7], 16)


defnow_str() ->str:
returndatetime.now().strftime("%Y-%m-%d %H:%M:%S")


deffmt_seconds(sec: int) ->str:
sec = int(sec)
h, rem = divmod(sec, 3600)
m, s = divmod(rem, 60)
ifh:
returnf"{h}小时{m}分"
ifm:
returnf"{m}分{s}秒"
returnf"{s}秒"


# ---------------------------------------------------------------------------
# 书库数据(books.json)
# ---------------------------------------------------------------------------

classStore:
def__init__(self, path: Path):
self.path = path
self.data = {"theme": "日间", "font_size": 14, "books": {}, "words": []}
self.load()

defload(self):
ifself.path.exists():
try:
data = json.loads(self.path.read_text(encoding="utf-8"))
ifisinstance(data, dict):
self.data.update({k: vfork, vindata.items()
ifkin ("theme", "font_size", "books", "words")})
except (json.JSONDecodeError, OSError):
bak = self.path.with_suffix(".json.bak")
try:
self.path.rename(bak)
exceptOSError:
pass

defsave(self):
fd, tmp = tempfile.mkstemp(
prefix="books_", suffix=".json", dir=str(self.path.parent))
try:
withos.fdopen(fd, "w", encoding="utf-8") asf:
json.dump(self.data, f, ensure_ascii=False, indent=1)
os.replace(tmp, self.path)
exceptOSError:
try:
os.remove(tmp)
exceptOSError:
pass

# -- 书 --
defget_book(self, key: str) ->dict|None:
returnself.data["books"].get(key)

defensure_book(self, key: str, title: str, fmt: str) ->dict:
books = self.data["books"]
ifkeynotinbooks:
books[key] = {
"title": title, "fmt": fmt, "added": now_str(),
"last_open": now_str(), "last_ts": 0.0, "seconds": 0,
"total": 0,
"progress": {"index": 0, "frac": 0.0}, "bookmarks": [],
            }
b = books[key]
b["title"], b["fmt"] = title, fmt
b.setdefault("seconds", 0)
b.setdefault("last_ts", 0.0)
b.setdefault("total", 0)
b.setdefault("progress", {"index": 0, "frac": 0.0})
b.setdefault("bookmarks", [])
returnb

defremove_book(self, key: str):
self.data["books"].pop(key, None)

# -- 生词 --
defadd_word(self, word: str, context: str, book: str):
word = word.strip()
ifnotword:
returnFalse
forwinself.data["words"]:
ifw["word"] == word:
returnFalse
self.data["words"].append({"word": word[:60], "context": context[:120],
"book": book, "time": now_str()})
returnTrue

defremove_word_at(self, idx: int):
if0<= idx<len(self.data["words"]):
self.data["words"].pop(idx)


# ---------------------------------------------------------------------------
# TXT:编码识别 + 按行分块 + 章节扫描
# ---------------------------------------------------------------------------

defdetect_encoding(sample: bytes) ->str:
importcodecs
ifsample.startswith(b"\xff\xfe") orsample.startswith(b"\xfe\xff"):
return"utf-16"
ifsample.startswith(b"\xef\xbb\xbf"):
return"utf-8-sig"
# 采样可能正好截断在多字节字符中间,用增量解码器(final=False)
forencin ("utf-8", "gb18030", "big5", "latin-1"):
try:
dec = codecs.getincrementaldecoder(enc)(errors="strict")
dec.decode(sample, final=False)
returnenc
exceptUnicodeDecodeError:
continue
return"gb18030"


classTxtBook:
"""大文件友好:扫描行边界生成字节偏移表,
    只在跳转时解码目标块,内存占用恒定。"""

def__init__(self, path: str|Path):
self.path = Path(path)
withopen(self.path, "rb") asf:
self.encoding = detect_encoding(f.read(262144))
# 块边界(字节偏移,全部位于换行符之后,
# UTF-8/GBK 下绝对不会切断多字节字符)
self.offsets = [0]
self.chapters = []          # (块序号, 标题)
chars = 0
withopen(self.path, "rb") asf:
forrawinf:
line = raw.decode(self.encoding, errors="replace")
stripped = line.strip()
iflen(stripped) <= 40andCHAPTER_RE.match(stripped):
block = len(self.offsets) -1
ifnotself.chaptersorself.chapters[-1][0] != block:
self.chapters.append((block, stripped))
chars += len(line)
ifchars>= BLOCK_CHARS:
self.offsets.append(f.tell())
chars = 0

@property
defunit_count(self) ->int:
returnlen(self.offsets)

deftitle(self, i: int) ->str:
pct = round(i*100/max(self.unit_count-1, 1))
returnf"第 {i + 1} 部分(约 {pct}%)"

defread_unit(self, i: int) ->str:
start = self.offsets[i]
end = self.offsets[i+1] ifi+1<len(self.offsets) elseNone
withopen(self.path, "rb") asf:
f.seek(start)
data = f.read() ifendisNoneelsef.read(end-start)
text = data.decode(self.encoding, errors="replace")
# 去掉 BOM 标记(只在第一块)
ifself.encoding.startswith("utf-8-sig") andi == 0andtext.startswith("\ufeff"):
text = text[1:]
returntext

deftoc(self) ->list[tuple[str, int]]:
ifself.chapters:
return [(t, i) fori, tinself.chapters]
step = max(self.unit_count//20, 1)
return [(self.title(i), i) foriinrange(0, self.unit_count, step)]

defclose(self):
pass


# ---------------------------------------------------------------------------
# EPUB:zip + OPF + NCX/Nav,纯标准库解析
# ---------------------------------------------------------------------------

_ATTR_RE = re.compile(r'([\w:.-]+)\s*=\s*"([^"]*)"')
_TAG_RE = re.compile(r"<[^>]+>")


def_attrs(tag: str) ->dict[str, str]:
return {m.group(1).lower(): m.group(2) formin_ATTR_RE.finditer(tag)}


class_HtmlToText(HTMLParser):
"""把 xhtml 章节转成纯文本,保留段落换行,丢弃 script/style。"""

BLOCK = {"p", "div", "br", "h1", "h2", "h3", "h4", "h5", "h6",
"li", "tr", "blockquote", "section", "article", "hr"}

def__init__(self):
super().__init__(convert_charrefs=True)
self.parts: list[str] = []
self._skip = 0

defhandle_starttag(self, tag, attrs):
iftagin ("script", "style"):
self._skip += 1
iftaginself.BLOCK:
self.parts.append("\n")

defhandle_endtag(self, tag):
iftagin ("script", "style") andself._skip:
self._skip -= 1
iftagin ("p", "h1", "h2", "h3", "h4", "h5", "h6", "div", "li"):
self.parts.append("\n")

defhandle_data(self, data):
ifnotself._skip:
self.parts.append(data)

deftext(self) ->str:
out = "".join(self.parts).replace("\xa0", " ")
out = re.sub(r"[ \t]*\n[ \t]*", "\n", out)
out = re.sub(r"\n{3,}", "\n\n", out)
returnout.strip()


classEpubBook:
def__init__(self, path: str|Path):
self.path = Path(path)
self.zf = zipfile.ZipFile(self.path)
names = set(self.zf.namelist())
opf_href = self._find_opf()
self.base = posixpath.dirname(opf_href)
opf = self._read_text(opf_href)

# manifest: id -> (href, media-type, properties)
manifest: dict[str, tuple[str, str, str]] = {}
forminre.finditer(r"<item\b[^>]*/?>", opf, flags=re.I|re.S):
a = _attrs(m.group(0))
if"id"inaand"href"ina:
manifest[a["id"]] = (a["href"], a.get("media-type", ""),
a.get("properties", ""))
# spine 顺序
spine_m = re.search(
r"<spine\b[^>]*>(.*?)</spine>", opf, flags=re.I|re.S)
idrefs = re.findall(
r'<itemref\b[^>]*idref="([^"]+)"',
spine_m.group(1) ifspine_melse"", flags=re.I)
self.hrefs: list[str] = []
forridinidrefs:
item = manifest.get(rid)
ifitem:
self.hrefs.append(self._norm(item[0]))

# 章节标题:先 NCX 后 Nav,最后回退文件名
titles = (self._titles_from_ncx(manifest) or
self._titles_from_nav(manifest))
self.titles: list[str] = []
forhrefinself.hrefs:
self.titles.append(titles.get(self._base_of(href), ""))

def_find_opf(self) ->str:
container = self.zf.read("META-INF/container.xml").decode(
"utf-8", "ignore")
m = re.search(r'<rootfile\b[^>]*full-path="([^"]+)"', container)
ifnotm:
raiseValueError("EPUB 缺少 container.xml 中的 rootfile")
returnm.group(1)

def_read_text(self, href: str) ->str:
raw = self.zf.read(href)
forencin ("utf-8-sig", "utf-8", "gb18030"):
try:
returnraw.decode(enc)
exceptUnicodeDecodeError:
continue
returnraw.decode("utf-8", errors="replace")

def_norm(self, href: str) ->str:
returnposixpath.normpath(
posixpath.join(self.base, unquote(href.split("#")[0])))

@staticmethod
def_base_of(href: str) ->str:
returnunquote(href.split("#")[0])

def_titles_from_ncx(self, manifest) ->dict[str, str]:
ncx = next((hforh, mt, _inmanifest.values()
if"ncx"inmt), None)
ifnotncx:
return {}
ncx_href = self._norm(ncx)
try:
xml = self._read_text(ncx_href)
exceptKeyError:
return {}
out: dict[str, str] = {}
pat = re.compile(
r"<navPoint\b.*?<text[^>]*>(.*?)</text>.*?"
r"<content\b[^>]*src=\"([^\"]+)\"",
flags=re.I|re.S)
forminpat.finditer(xml):
label = _TAG_RE.sub("", m.group(1)).strip()
iflabel:
out.setdefault(self._base_of(self._norm(m.group(2))), label)
returnout

def_titles_from_nav(self, manifest) ->dict[str, str]:
nav = next((hforh, _, propinmanifest.values()
if"nav"inprop.split()), None)
ifnotnav:
return {}
try:
xml = self._read_text(self._norm(nav))
exceptKeyError:
return {}
out: dict[str, str] = {}
forminre.finditer(
r'<a\b[^>]*href="([^"]+)"[^>]*>(.*?)</a>',
xml, flags=re.I|re.S):
label = _TAG_RE.sub("", m.group(2)).strip()
iflabel:
out.setdefault(self._base_of(self._norm(m.group(1))), label)
returnout

@property
defunit_count(self) ->int:
returnlen(self.hrefs)

deftitle(self, i: int) ->str:
t = self.titles[i] ifi<len(self.titles) else""
returntorf"第 {i + 1} 章"

defread_unit(self, i: int) ->str:
href = self.hrefs[i]
parser = _HtmlToText()
parser.feed(self._read_text(href))
returnparser.text() or"(本章无正文内容)"

deftoc(self) ->list[tuple[str, int]]:
return [(self.title(i), i) foriinrange(self.unit_count)]

defclose(self):
try:
self.zf.close()
exceptException:
pass


defopen_book_file(path: str|Path):
p = Path(path)
suf = p.suffix.lower()
ifsuf == ".txt":
returnTxtBook(p)
ifsuf == ".epub":
returnEpubBook(p)
raiseValueError("仅支持 .txt 与 .epub 文件")


# ---------------------------------------------------------------------------
# 界面
# ---------------------------------------------------------------------------

defmake_button(master, text, cmd, kind="primary", font_size=9):
bg = {"primary": ACCENT, "ghost": CARD_BG, "soft": "#f0f2f9"}.get(kind, ACCENT)
fg = "#ffffff"ifkind == "primary"elseTEXT_DARK
hover = ACCENT_DARKifkind == "primary"else"#e3e7f2"
btn = tk.Button(master, text=text, command=cmd, bg=bg, fg=fg,
activebackground=hover, activeforeground=fg,
relief="flat", cursor="hand2", bd=0,
font=(FONT, font_size, "bold"ifkind == "primary"else"normal"),
padx=10, pady=4)
btn.bind("<Enter>", lambdae: btn.config(bg=hover))
btn.bind("<Leave>", lambdae: btn.config(bg=bg))
ifkindin ("ghost", "soft"):
btn.config(highlightbackground=BORDER, highlightthickness=1)
returnbtn


defask_text(parent, title: str, prompt: str, initial: str = "") ->str|None:
"""轻量扁平输入弹窗(不使用丑陋的默认 simpledialog)。"""
top = tk.Toplevel(parent)
top.title(title)
top.configure(bg=CARD_BG)
top.resizable(False, False)
top.transient(parent)
top.grab_set()
result = {"v": None}
tk.Label(top, text=prompt, bg=CARD_BG, fg=TEXT_DARK,
font=(FONT, 9, "bold")).pack(anchor="w", padx=16, pady=(14, 6))
var = tk.StringVar(value=initial)
ent = tk.Entry(top, textvariable=var, font=(FONT, 10), width=34,
relief="solid", bd=1)
ent.pack(padx=16, pady=(0, 12), ipady=3)
ent.focus_set()
ent.select_range(0, "end")

defok():
result["v"] = var.get().strip()
top.destroy()

row = tk.Frame(top, bg=CARD_BG)
row.pack(pady=(0, 14))
make_button(row, "取消", top.destroy, "soft").pack(side="right", padx=(6, 16))
make_button(row, "确定", ok, "primary").pack(side="right")
top.bind("<Return>", lambdae: ok())
top.bind("<Escape>", lambdae: top.destroy())
parent.wait_window(top)
returnresult["v"]


classReaderApp(tk.Tk):
def__init__(self):
super().__init__()
enable_dpi()
self.title("本地电子书阅读器")
self.geometry("1120x780")
self.minsize(960, 680)
self.configure(bg=APP_BG)

self.store = Store(app_dir() /DATA_FILE)
self.book = None# TxtBook / EpubBook
self.book_key = ""
self.meta: dict|None = None
self.unit_index = 0
self._tick_seconds = 0

self._setup_style()
self._build_banner()
self._build_toolbar()
self._build_main()
self._build_statusbar()
self._apply_reader_theme()

self.protocol("WM_DELETE_WINDOW", self.on_close)
self.bind("<Alt-Left>", lambdae: self.goto_prev_unit())
self.bind("<Alt-Right>", lambdae: self.goto_next_unit())
self.bind("<Control-plus>", lambdae: self.change_font(1))
self.bind("<Control-minus>", lambdae: self.change_font(-1))

self.refresh_library()
self.refresh_words()
self.after(SAVE_INTERVAL_MS, self.auto_save)
self.after(TICK_MS, self.tick)
# 自动续读上次打开的书
self.after(150, self.reopen_last)

# ---------------- 样式 ----------------
def_setup_style(self):
st = ttk.Style(self)
try:
st.theme_use("clam")
excepttk.TclError:
pass
st.configure(".", background=APP_BG, font=(FONT, 9))
st.configure("TNotebook", background=APP_BG, borderwidth=0)
st.configure("TNotebook.Tab", font=(FONT, 9, "bold"), padding=(12, 5),
background="#dde3f2", foreground=TEXT_GRAY)
st.map("TNotebook.Tab", background=[("selected", CARD_BG)],
foreground=[("selected", ACCENT_DARK)])
st.configure("Treeview", font=(FONT, 9), rowheight=23,
background=CARD_BG, fieldbackground=CARD_BG, borderwidth=0)
st.configure("Treeview.Heading", font=(FONT, 9, "bold"),
background=HEADER_BG, foreground="#ffffff",
relief="flat", padding=3)
st.map("Treeview.Heading", background=[("active", "#34495e")])
st.configure("TCombobox", padding=2)

def_build_banner(self):
self.banner = tk.Canvas(self, height=70, highlightthickness=0, bg=GRAD1)
self.banner.pack(fill="x")
self.banner.bind("<Configure>", self._draw_grad)

def_draw_grad(self, _evt=None):
w, h = self.banner.winfo_width(), 70
self.banner.delete("all")
r1, g1, b1 = hex_rgb(GRAD1)
r2, g2, b2 = hex_rgb(GRAD2)
foriinrange(h):
t = i/max(h-1, 1)
color = "#%02x%02x%02x"% (int(r1+ (r2-r1) *t),
int(g1+ (g2-g1) *t),
int(b1+ (b2-b1) *t))
self.banner.create_line(0, i, w, i, fill=color)
self.banner.create_text(22, 24, anchor="w", text="本地电子书阅读器",
font=(FONT, 16, "bold"), fill="#ffffff")
self.banner.create_text(22, 52, anchor="w",
text="TXT / EPUB 离线阅读 · 自动续读 · 书签 · 生词本 · 护眼/夜间模式",
font=(FONT, 9), fill="#e8eaff")

# ---------------- 工具栏 ----------------
def_build_toolbar(self):
bar = tk.Frame(self, bg=CARD_BG,
highlightbackground=BORDER, highlightthickness=1)
bar.pack(fill="x", padx=10, pady=(8, 6))
make_button(bar, "打开新书", self.open_dialog, "primary"
                    ).pack(side="left", padx=(10, 6), pady=6)
make_button(bar, "◀ 上一部分", self.goto_prev_unit, "soft"
                    ).pack(side="left", padx=3)
make_button(bar, "下一部分 ▶", self.goto_next_unit, "soft"
                    ).pack(side="left", padx=3)
ttk.Separator(bar, orient="vertical").pack(
side="left", fill="y", padx=8, pady=4)
make_button(bar, "A-", lambda: self.change_font(-1), "soft"
                    ).pack(side="left", padx=2)
make_button(bar, "A+", lambda: self.change_font(1), "soft"
                    ).pack(side="left", padx=2)
tk.Label(bar, text="主题", bg=CARD_BG, fg=TEXT_GRAY,
font=(FONT, 9)).pack(side="left", padx=(10, 2))
self.theme_var = tk.StringVar(value=self.store.data["theme"])
cb = ttk.Combobox(bar, textvariable=self.theme_var,
values=list(THEMES), state="readonly",
width=6, font=(FONT, 9))
cb.pack(side="left")
cb.bind("<<ComboboxSelected>>",
lambdae: self._apply_reader_theme(save=True))
ttk.Separator(bar, orient="vertical").pack(
side="left", fill="y", padx=8, pady=4)
make_button(bar, "添加书签", self.add_bookmark, "soft"
                    ).pack(side="left", padx=2)
make_button(bar, "选中存生词", self.save_selection_word, "soft"
                    ).pack(side="left", padx=2)

# ---------------- 主体:左侧栏 + 阅读区 ----------------
def_build_main(self):
pane = tk.PanedWindow(self, orient="horizontal", sashwidth=6,
bg=APP_BG, bd=0, sashrelief="flat")
pane.pack(fill="both", expand=True, padx=10, pady=(0, 6))

side = tk.Frame(pane, bg=APP_BG, width=286)
nb = ttk.Notebook(side)
nb.pack(fill="both", expand=True)
self.side_nb = nb

# 书库
lib_tab = tk.Frame(nb, bg=APP_BG)
nb.add(lib_tab, text="书库")
self.lib_tree = ttk.Treeview(
lib_tab, columns=("pct", "sec"),
show="tree headings", selectmode="browse")
self.lib_tree.heading("#0", text="书名")
self.lib_tree.heading("pct", text="进度")
self.lib_tree.heading("sec", text="时长")
self.lib_tree.column("#0", width=168)
self.lib_tree.column("pct", width=48, anchor="center")
self.lib_tree.column("sec", width=56, anchor="center")
lsb = ttk.Scrollbar(lib_tab, orient="vertical",
command=self.lib_tree.yview)
self.lib_tree.configure(yscrollcommand=lsb.set)
self.lib_tree.pack(side="left", fill="both", expand=True)
lsb.pack(side="right", fill="y")
self.lib_tree.bind("<Double-1>",
lambdae: self.open_selected_library())
self.lib_tree.bind("<Button-3>", self._lib_menu)

# 目录
toc_tab = tk.Frame(nb, bg=APP_BG)
nb.add(toc_tab, text="目录")
self.toc_tree = ttk.Treeview(toc_tab, show="tree", selectmode="browse")
tsb = ttk.Scrollbar(toc_tab, orient="vertical",
command=self.toc_tree.yview)
self.toc_tree.configure(yscrollcommand=tsb.set)
self.toc_tree.pack(side="left", fill="both", expand=True)
tsb.pack(side="right", fill="y")
self.toc_tree.bind("<Double-1>", lambdae: self.jump_toc())

# 书签
bm_tab = tk.Frame(nb, bg=APP_BG)
nb.add(bm_tab, text="书签")
self.bm_tree = ttk.Treeview(
bm_tab, columns=("pos",), show="tree headings")
self.bm_tree.heading("#0", text="书签")
self.bm_tree.heading("pos", text="位置")
self.bm_tree.column("#0", width=176)
self.bm_tree.column("pos", width=96, anchor="center")
bsb = ttk.Scrollbar(bm_tab, orient="vertical",
command=self.bm_tree.yview)
self.bm_tree.configure(yscrollcommand=bsb.set)
self.bm_tree.pack(side="left", fill="both", expand=True)
bsb.pack(side="right", fill="y")
self.bm_tree.bind("<Double-1>", lambdae: self.jump_bookmark())
self.bm_tree.bind("<Button-3>", self._bm_menu)

# 生词本
w_tab = tk.Frame(nb, bg=APP_BG)
nb.add(w_tab, text="生词本")
self.word_tree = ttk.Treeview(
w_tab, columns=("book",), show="tree headings")
self.word_tree.heading("#0", text="生词 / 短语")
self.word_tree.heading("book", text="出处")
self.word_tree.column("#0", width=160)
self.word_tree.column("book", width=112)
wsb = ttk.Scrollbar(w_tab, orient="vertical",
command=self.word_tree.yview)
self.word_tree.configure(yscrollcommand=wsb.set)
self.word_tree.pack(side="left", fill="both", expand=True)
wsb.pack(side="right", fill="y")
self.word_tree.bind("<Button-3>", self._word_menu)
self.word_tree.bind("<Double-1>",
lambdae: self._show_word_context())

pane.add(side, minsize=240, stretch="never")
read_frame = tk.Frame(pane, bg=CARD_BG,
highlightbackground=BORDER, highlightthickness=1)
bg, fg = THEMES[self.store.data["theme"]]
self.reader = tk.Text(
read_frame, wrap="word", state="disabled",
bg=bg, fg=fg, relief="flat", bd=0,
padx=28, pady=20, spacing1=1, spacing2=7,
font=(FONT, self.store.data["font_size"]),
cursor="arrow", highlightthickness=0, insertwidth=0)
rsb = ttk.Scrollbar(read_frame, orient="vertical",
command=self.reader.yview)
self.reader.configure(yscrollcommand=rsb.set)
self.reader.pack(side="left", fill="both", expand=True)
rsb.pack(side="right", fill="y")
self.reader.bind("<Button-3>", lambdae: self._reader_menu(e))
pane.add(read_frame, minsize=420, stretch="always")

self._menu = tk.Menu(self, tearoff=0, font=(FONT, 9))

def_build_statusbar(self):
self.status_var = tk.StringVar(
value="就绪:点击左上角「打开新书」,或双击书库中的书续读")
bar = tk.Label(self, textvariable=self.status_var, bg=HEADER_BG,
fg="#cfd8e8", font=(FONT, 8), anchor="w",
padx=10, pady=4)
bar.pack(fill="x", side="bottom")

# ---------------- 主题/字号 ----------------
def_apply_reader_theme(self, save=False):
name = self.theme_var.get() ifhasattr(self, "theme_var") \
elseself.store.data["theme"]
bg, fg = THEMES.get(name, THEMES["日间"])
self.reader.config(bg=bg, fg=fg, insertbackground=fg)
ifsave:
self.store.data["theme"] = name
self.store.save()

defchange_font(self, delta: int):
size = max(11, min(30, self.store.data["font_size"] +delta))
self.store.data["font_size"] = size
self.reader.config(font=(FONT, size))
self.store.save()
self._toast(f"字号:{size}")

# ---------------- 打开书 ----------------
defopen_dialog(self):
paths = filedialog.askopenfilenames(
title="选择 TXT / EPUB 电子书",
filetypes=[("电子书", "*.txt *.epub"), ("TXT 文本", "*.txt"),
                       ("EPUB 电子书", "*.epub"), ("所有文件", "*.*")])
ifpaths:
self.open_path(paths[0])

defreopen_last(self):
candidates = sorted(
self.store.data["books"].items(),
key=lambdakv: kv[1].get("last_ts", 0.0), reverse=True)
forkey, _incandidates:
ifPath(key).exists():
self.open_path(key)
return
self._show_welcome()

defopen_path(self, path: str):
path = str(Path(path))
ifnotPath(path).exists():
ifmessagebox.askyesno(
"文件不存在",
f"文件已被移动或删除:\n{path}\n\n"
"是否从书库中移除记录?"):
self.store.remove_book(path)
self.store.save()
self.refresh_library()
return
self.save_current_progress()
ifself.book:
self.book.close()
self.book = None
try:
self._loading_text("正在打开,请稍候……")
self.update_idletasks()
self.book = open_book_file(path)
except (zipfile.BadZipFile, KeyError, ValueError, OSError) ase:
self._show_welcome()
messagebox.showerror("打开失败", f"无法识别的电子书:\n{e}")
return
p = Path(path)
title = p.stem
self.book_key = path
self.meta = self.store.ensure_book(
path, title,
"epub"ifp.suffix.lower() == ".epub"else"txt")
self.meta["last_open"] = now_str()
self.meta["last_ts"] = time.time()
self.meta["total"] = self.book.unit_count
self.unit_index = max(0, min(
self.meta["progress"].get("index", 0),
self.book.unit_count-1))
self.load_unit(
self.unit_index, self.meta["progress"].get("frac", 0.0))
self.refresh_toc()
self.refresh_bookmarks()
self.refresh_library(select=path)
self.store.save()

defopen_selected_library(self):
sel = self.lib_tree.selection()
ifsel:
self.open_path(sel[0])

# ---------------- 单元加载/跳转 ----------------
defload_unit(self, index: int, frac: float = 0.0):
ifnotself.book:
return
index = max(0, min(index, self.book.unit_count-1))
self.unit_index = index
try:
text = self.book.read_unit(index)
exceptOSErrorase:
messagebox.showerror("读取失败", str(e))
return
bg, fg = THEMES[self.store.data["theme"]]
self.reader.config(state="normal", bg=bg, fg=fg, cursor="xterm",
font=(FONT, self.store.data["font_size"]))
self.reader.delete("1.0", "end")
self.reader.insert("1.0", text)
self.reader.config(state="disabled")
self.update_idletasks()
self.reader.yview_moveto(max(0.0, min(frac, 1.0)))
ifself.metaisnotNone:
self.meta["progress"] = {"index": index,
"frac": round(max(0.0, min(frac, 1.0)), 4)}
self._update_status()

defgoto_prev_unit(self):
ifself.bookandself.unit_index>0:
self.load_unit(self.unit_index-1, 0.99)

defgoto_next_unit(self):
ifself.bookandself.unit_index<self.book.unit_count-1:
self.load_unit(self.unit_index+1, 0.0)

defjump_toc(self):
ifnotself.book:
return
sel = self.toc_tree.selection()
ifnotsel:
return
idx = int(sel[0])
self.save_current_progress()
self.load_unit(idx, 0.0)

def_current_frac(self) ->float:
try:
returnfloat(self.reader.yview()[0])
excepttk.TclError:
return0.0

defsave_current_progress(self):
ifself.bookandself.metaisnotNone:
self.meta["progress"] = {"index": self.unit_index,
"frac": round(self._current_frac(), 4)}

# ---------------- 书签 ----------------
defadd_bookmark(self):
ifnotself.book:
self._toast("请先打开一本书")
return
self.save_current_progress()
default = self.book.title(self.unit_index)
label = ask_text(self, "添加书签", "给这个位置起个名字:", default)
iflabelisNone:
return
self.meta["bookmarks"].append({
"label": labelordefault,
"index": self.unit_index,
"frac": round(self._current_frac(), 4),
"time": now_str(),
        })
self.store.save()
self.refresh_bookmarks()
self._toast(f"已添加书签:{label}")

defrefresh_bookmarks(self):
self.bm_tree.delete(*self.bm_tree.get_children())
ifnotself.meta:
return
fori, bminenumerate(self.meta["bookmarks"]):
self.bm_tree.insert(
"", "end", iid=str(i),
text=bm["label"],
values=(f"第 {bm['index'] + 1} 节",))

defjump_bookmark(self):
ifnotself.book:
return
sel = self.bm_tree.selection()
ifnotsel:
return
bm = self.meta["bookmarks"][int(sel[0])]
self.save_current_progress()
self.load_unit(bm["index"], bm.get("frac", 0.0))

def_bm_menu(self, event):
iid = self.bm_tree.identify_row(event.y)
ifnotiid:
return
self.bm_tree.selection_set(iid)
self.menu_clear()
self._menu.add_command(label="跳转到书签", command=self.jump_bookmark)
self._menu.add_command(label="删除该书签", command=self.delete_bookmark)
self._menu.tk_popup(event.x_root, event.y_root)

defdelete_bookmark(self):
sel = self.bm_tree.selection()
ifnotsel:
return
idx = int(sel[0])
bm = self.meta["bookmarks"][idx]
ifmessagebox.askyesno("删除书签",
f"确定删除书签「{bm['label']}」?"):
self.meta["bookmarks"].pop(idx)
self.store.save()
self.refresh_bookmarks()

# ---------------- 生词本 ----------------
defsave_selection_word(self):
ifnotself.book:
self._toast("请先打开一本书")
return
try:
sel = self.reader.get("sel.first", "sel.last")
excepttk.TclError:
sel = ""
sel = sel.strip()
ifnotsel:
self._toast("请先在正文中选中要保存的词或句子")
return
iflen(sel) >60:
ifnotmessagebox.askyesno(
"内容较长",
f"选中内容有 {len(sel)} 字,仍要作为一条生词保存吗?"):
return
context = ""
try:
line_no = int(self.reader.index("sel.first").split(".")[0])
context = self.reader.get(f"{line_no}.0", f"{line_no}.end").strip()
except (tk.TclError, ValueError):
pass
ifself.store.add_word(sel, context, self.meta["title"]):
self.store.save()
self.refresh_words()
self._toast(f"已加入生词本:{sel[:20]}")
else:
self._toast("生词本里已经有这个词了")

defrefresh_words(self):
self.word_tree.delete(*self.word_tree.get_children())
fori, winenumerate(self.store.data["words"]):
self.word_tree.insert(
"", "end", iid=str(i), text=w["word"],
values=(w["book"],))

def_word_menu(self, event):
iid = self.word_tree.identify_row(event.y)
ifnotiid:
return
self.word_tree.selection_set(iid)
self.menu_clear()
self._menu.add_command(label="查看语境",
command=lambda: self._show_word_context())
self._menu.add_command(label="删除该生词", command=self.delete_word)
self._menu.tk_popup(event.x_root, event.y_root)

def_show_word_context(self, _event=None):
sel = self.word_tree.selection()
ifnotsel:
return
w = self.store.data["words"][int(sel[0])]
messagebox.showinfo(
w["word"][:40],
f"生词/短语:{w['word']}\n\n"
f"出处:《{w['book']}》\n"
f"时间:{w['time']}\n\n"
f"语境:\n{w['context'] or '(无)'}")

defdelete_word(self):
sel = self.word_tree.selection()
ifnotsel:
return
idx = int(sel[0])
w = self.store.data["words"][idx]
ifmessagebox.askyesno("删除生词",
f"从生词本删除「{w['word']}」?"):
self.store.remove_word_at(idx)
self.store.save()
self.refresh_words()

def_reader_menu(self, event):
self.menu_clear()
self._menu.add_command(
label="选中内容存入生词本", command=self.save_selection_word)
ifself.book:
self._menu.add_command(
label="在此处添加书签", command=self.add_bookmark)
self._menu.tk_popup(event.x_root, event.y_root)

# ---------------- 书库/目录列表 ----------------
defrefresh_library(self, select: str|None = None):
existing = self.lib_tree.get_children()
ifexisting:
self.lib_tree.delete(*existing)
items = sorted(self.store.data["books"].items(),
key=lambdakv: kv[1].get("last_ts", 0.0), reverse=True)
forkey, binitems:
exists = Path(key).exists()
title = b["title"] + (""ifexistselse"(文件缺失)")
pct = self._progress_pct(b)
self.lib_tree.insert(
"", "end", iid=key, text=title,
values=(f"{pct}%", fmt_seconds(b.get("seconds", 0))))
ifselectandself.lib_tree.exists(select):
self.lib_tree.selection_set(select)

def_progress_pct(self, b: dict) ->int:
total = b.get("total", 0)
iftotal<= 0:
return0
idx = b.get("progress", {}).get("index", 0)
frac = b.get("progress", {}).get("frac", 0.0)
returnmin(100, round((idx+frac) *100/total))

defrefresh_toc(self):
self.toc_tree.delete(*self.toc_tree.get_children())
ifnotself.book:
return
fortitle, idxinself.book.toc():
self.toc_tree.insert("", "end", iid=str(idx), text=title)

def_lib_menu(self, event):
iid = self.lib_tree.identify_row(event.y)
ifnotiid:
return
self.lib_tree.selection_set(iid)
self.menu_clear()
self._menu.add_command(label="打开 / 续读",
command=self.open_selected_library)
self._menu.add_command(label="在资源管理器中显示",
command=lambda: self._reveal(iid))
self._menu.add_command(label="从书库移除(不删原文件)",
command=lambda: self.remove_library(iid))
self._menu.tk_popup(event.x_root, event.y_root)

def_reveal(self, key: str):
try:
ifsys.platform.startswith("win"):
importsubprocess
subprocess.run(
                    ["explorer", "/select,", os.path.normpath(key)],
check=False)
else:
os.startfile(str(Path(key).parent))
exceptOSError:
pass

defremove_library(self, key: str):
b = self.store.get_book(key)
ifbandmessagebox.askyesno(
"移出书库",
f"把《{b['title']}》从书库移除吗?\n"
"(进度与书签会删除,原电子书文件不受影响)"):
ifkey == self.book_key:
self._toast("请先关闭正在读的这本书再移除")
return
self.store.remove_book(key)
self.store.save()
self.refresh_library()

defmenu_clear(self):
self._menu.delete(0, "end")

# ---------------- 计时 / 自动保存 ----------------
deftick(self):
ifself.bookandself.state() == "normal":
ifself.metaisnotNone:
self.meta["seconds"] = (
self.meta.get("seconds", 0) +TICK_MS//1000)
self._tick_seconds += TICK_MS//1000
self._update_status()
self.after(TICK_MS, self.tick)

defauto_save(self):
ifself.book:
self.save_current_progress()
self.store.save()
self._update_current_library_row()
self.after(SAVE_INTERVAL_MS, self.auto_save)

def_update_current_library_row(self):
"""原地更新当前书的进度/时长,
        避免整树重建造成的选中与滚动跳动。"""
ifnotself.metaornotself.lib_tree.exists(self.book_key):
return
self.lib_tree.item(
self.book_key,
values=(f"{self._progress_pct(self.meta)}%",
fmt_seconds(self.meta.get("seconds", 0))))

# ---------------- 杂项 ----------------
def_loading_text(self, msg: str):
self.reader.config(state="normal", bg=CARD_BG, fg=TEXT_GRAY,
font=(FONT, 12), cursor="arrow")
self.reader.delete("1.0", "end")
self.reader.insert("1.0", "\n\n\t"+msg)
self.reader.config(state="disabled")

def_show_welcome(self):
self.reader.config(state="normal", bg=CARD_BG, fg=TEXT_GRAY,
font=(FONT, 12), cursor="arrow")
self.reader.delete("1.0", "end")
self.reader.insert("1.0",
"\n\n\n\t还没有打开的书\n\n"
"\t点击左上角「打开新书」,选择本地 TXT / EPUB;\n"
"\t或在左侧「书库」双击任意一本书续读。\n\n"
"\t· 阅读进度、书签自动保存,下次接着读\n"
"\t· 三档主题、字号可调,支持大文件分块加载")
self.reader.config(state="disabled")

def_update_status(self):
ifnotself.bookorself.metaisNone:
return
idx, total = self.unit_index+1, self.book.unit_count
frac = self._current_frac()
pct = round(((self.unit_index+frac) /total) *100)
title = self.meta["title"]
self.status_var.set(
f"《{title}》 {self.book.title(self.unit_index)}({idx}/{total})"
f" 全书进度约 {pct}% | 累计阅读 "
f"{fmt_seconds(self.meta.get('seconds', 0))}"
f" | Alt+←/→ 切换章节,右键正文加书签/存生词")

def_toast(self, msg: str):
self.status_var.set(msg)

defon_close(self):
try:
self.save_current_progress()
self.store.save()
ifself.book:
self.book.close()
exceptOSError:
pass
self.destroy()


defmain():
app = ReaderApp()
app.mainloop()


if__name__ == "__main__":
main()
十三、常见问题
1. 为什么不支持 PDF / MOBI?PDF 的排版和图片解析非常复杂,MOBI 虽然是一种过时的 Kindle 格式但也需要第三方库(mobi 或 kcc)。本文刻意保持零依赖,只支持 TXT(最通用)和 EPUB(最主流的开放格式)。如果需要 PDF/MOBI,可以用 pypdf/pdfminer/mobi 扩展 open_book_file。
2. 编码识别不准怎么办?detect_encoding 采样前 256KB,如果你的编码不是 UTF-8 / GB18030 / Big5 / Latin-1 之一,可以在编码列表里加一行。gb18030 作为兜底,对绝大多数中文小说够用。
3. 进度为什么要用 index + frac 两个数?只记 index(章节号)粒度太粗——一章可能 200 屏;只记 frac 又不知道 frac 是在哪一章。两者结合才能精确到"第几章第几个滚动条位置"。
4. 临时文件怎么清?tempfile.mkstemp 创建的 .json 临时文件在正常保存后被 os.replace 原子替换(临时文件本身被覆盖),不会残留。如果程序崩溃导致临时文件没被替换,它会留在 books.json 同目录下,手动删掉即可。
5. 生词本重复检测是精确匹配吗?是,完全相同的字符串才算重复。如果想近似匹配(比如 "hello" 和 "hello world"),可以在 add_word 里加相似度阈值判断。

